逆向工具 REA 登顶 GitHub?二进制破解加剧移动端如何防作弊
 openinstall运营团队|
 2026-10-12|
 1271
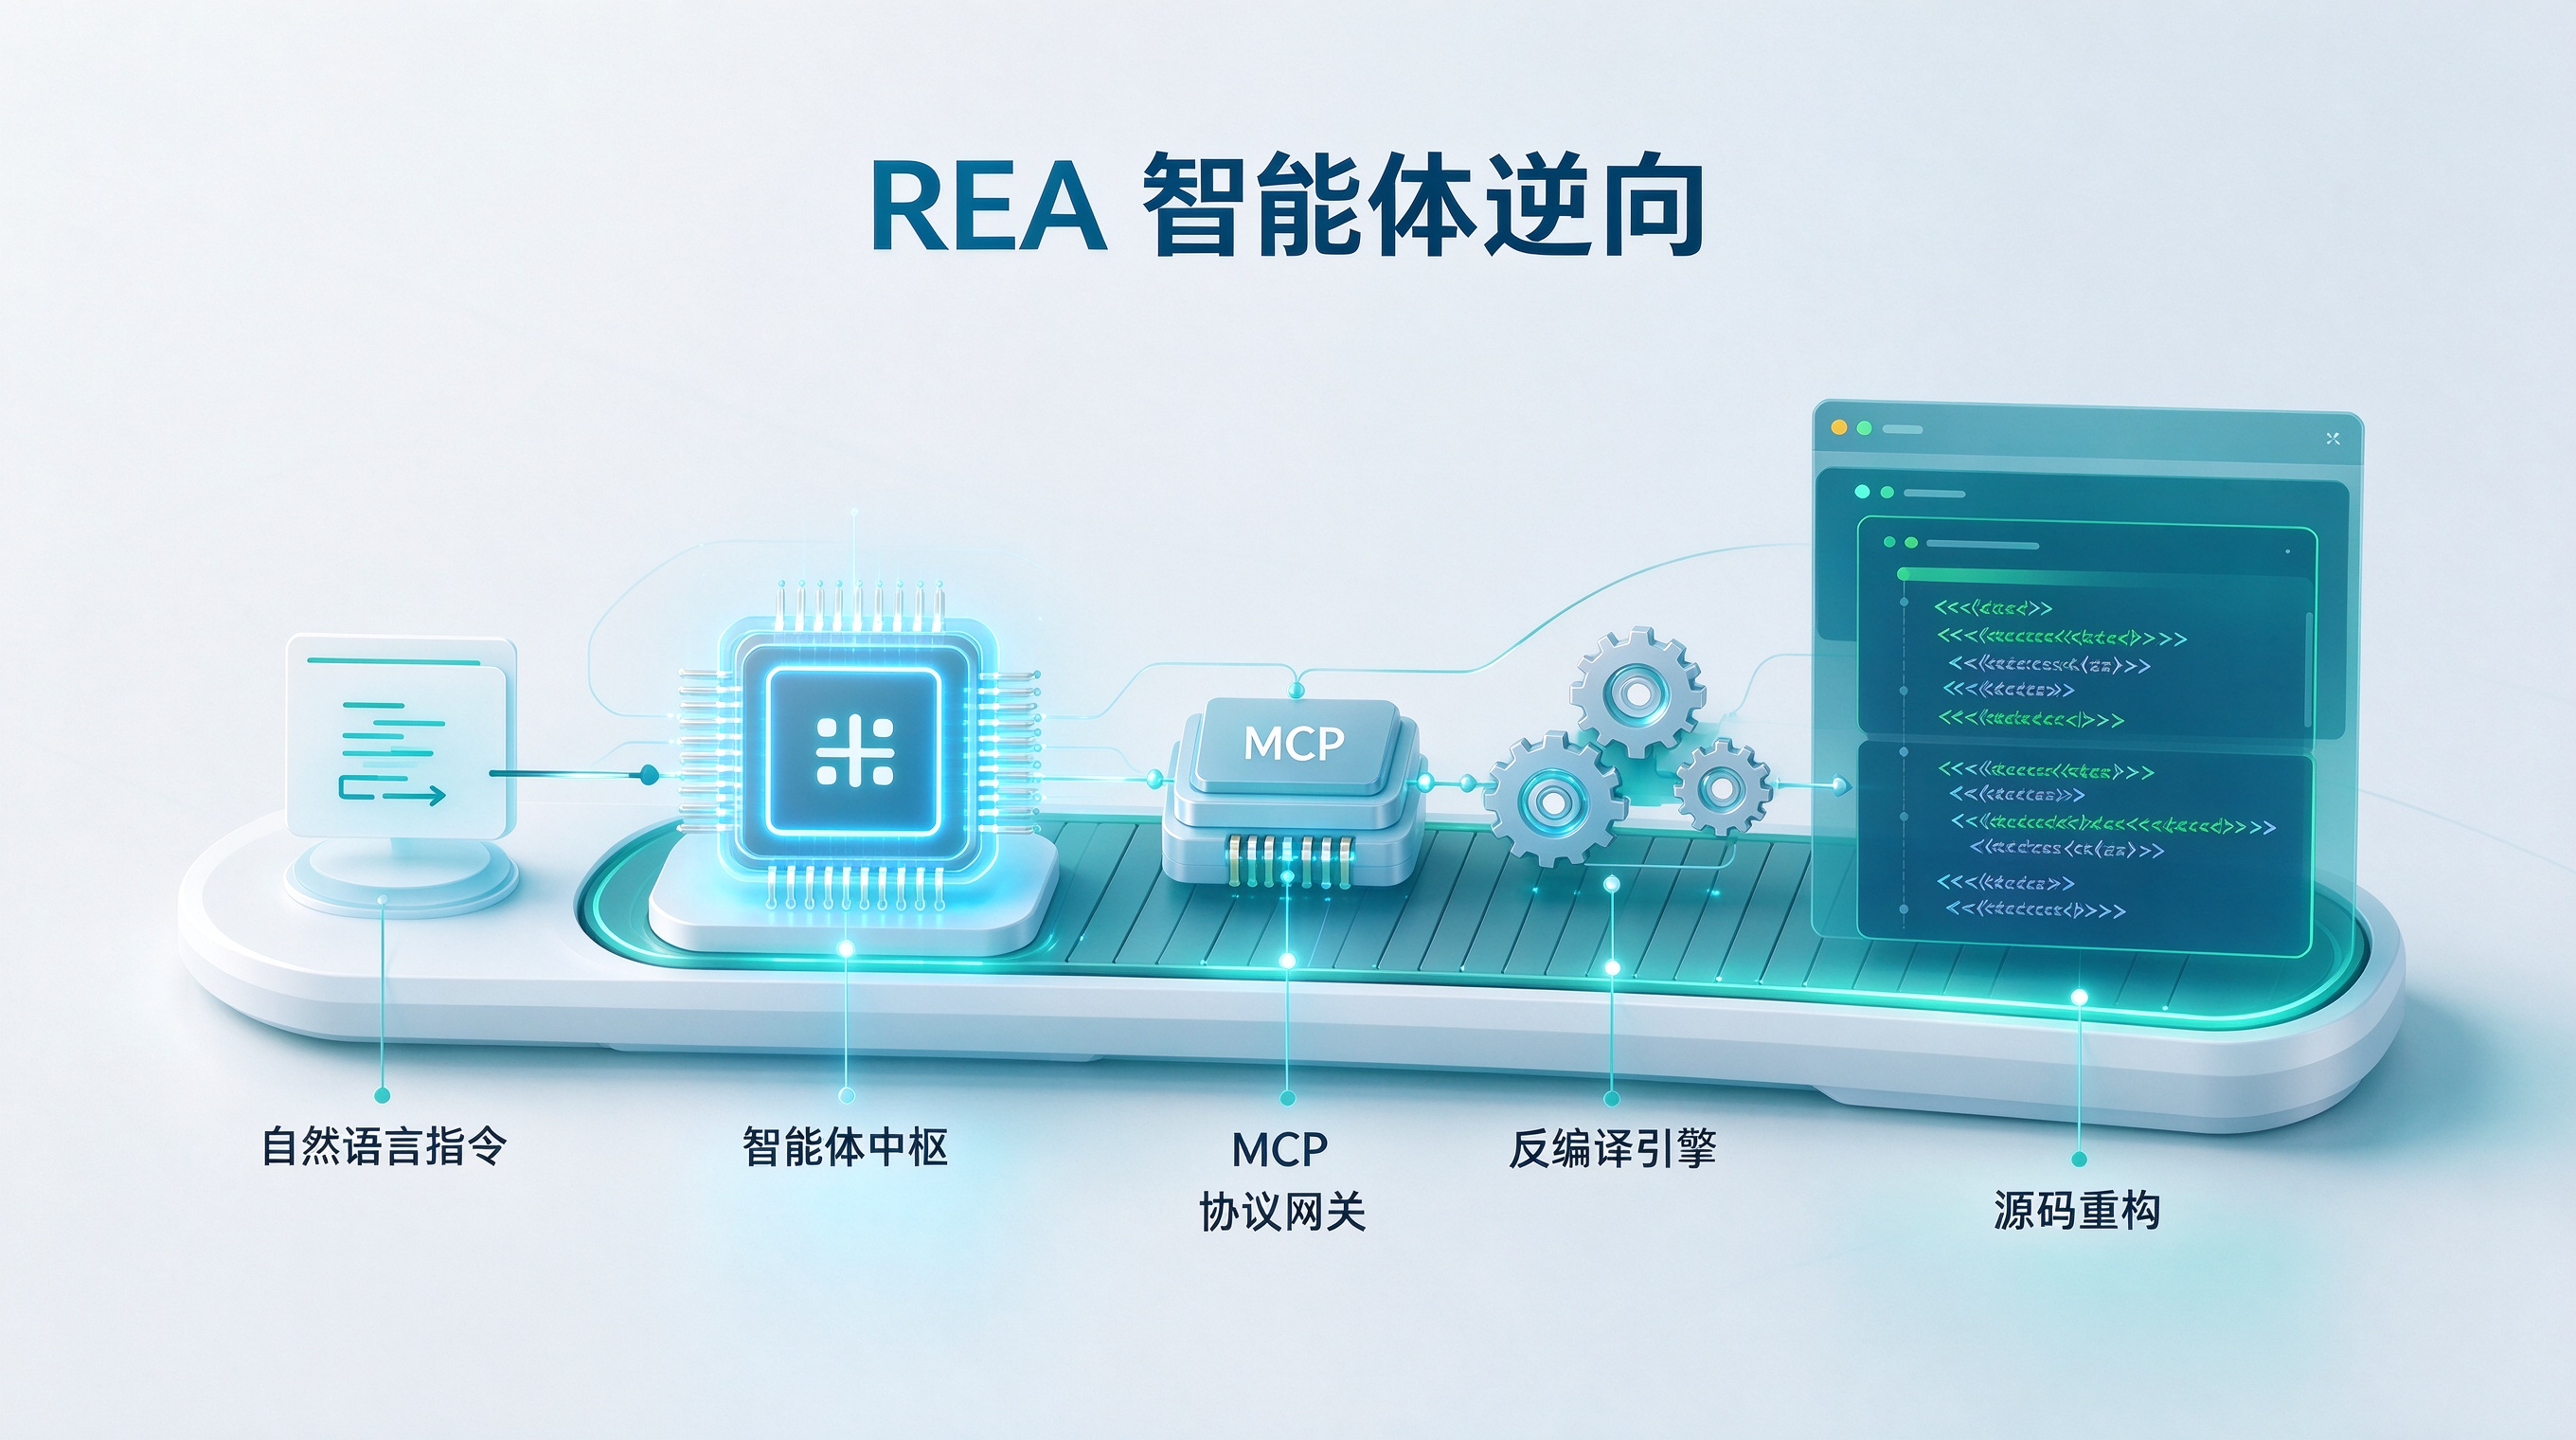
逆向工具 REA 登顶 GitHub?这一技术突变已被确证,随着开源项目 REA(Reverse Engineer Anything)在短短三天内狂揽近 8 万颗 GitHub Star 并登顶 Trending 榜首,逆向工具 REA 一天登顶 GitHub 引发了全行业对商业软件底层安全与代码闭源护城河的广泛焦虑。这款工具通过模型上下文协议(MCP)打通了 Claude Code、Codex 等前沿编码智能体与 Ghidra、Hopper 等专业反编译引擎的底层数据链路,让开发者仅需自然语言指令即可快速剖析商业应用的机器码、反推业务逻辑并重构可用源码。当逆向工程从过去少数高手的精细手艺蜕变为大模型驱动的自动化流水线,黑灰产的破解与作弊成本被瞬间拉低,移动端应用原有的安全假设全面失效,如何在客户端底层构建抵御自动化逆向与伪造调用的全新防护壁垒,已成为工程团队不得不面对的生死课题。
逆向质变:从黑客玄学到智能体驱动的自动化拆解
在传统的软件工程认知中,商业公司将高阶业务逻辑编译为原生机器码(Native Code)或字节码后,便形成了天然的技术壁垒。普通工程师面对 ELF、Mach-O 或 DEX 文件如同阅读天书;即便是顶尖的安全研究员或黑客,想要复现一套成熟软件的关键功能,也需要耗费数周时间在 IDA Pro 或 Ghidra 中单步调试汇编指令、梳理符号引用表并逐步推断数据结构。
REA 的核心突破在于其充当了高阶大语言模型与专业底层逆向工具之间的结构化桥梁。它依托开源的 MCP 协议,将反编译分析、汇编代码解析、控制流图提取以及函数调用拓扑等繁杂动作封装为标准工具接口,提供给上层具备长程推理能力的智能体调用。
[REA 自动化逆向工程执行流程]
用户输入自然语言目标(如“分析某应用的本地缓存校验机制”)
↓
[Claude Code / Codex 智能体规划]
自主拆解分析步骤,生成逆向任务调用链
↓
[MCP 协议调用 REA 核心服务]
唤起本地 Ghidra / Hopper 执行原生二进制反编译
↓
[汇编与伪代码上下文注入大模型]
智能体阅读控制流、识别核心加密与校验函数
↓
[源码重构与接口还原]
输出结构清晰的高级语言(如 C++ / Rust)工程实现
整个逆向过程呈现出颠覆传统安全攻防认知的典型特征:
- 逆向分析的门槛彻底消失:逆向人员不再需要精通 x86-64 或 ARM64 指令集中的跳转与寄存器分配,只需向智能体下达业务维度的意图,大模型便会自主遍历可疑函数并提炼业务逻辑;
- 逆向效率发生指数级跃迁:过去以“周”为单位的算法逆向被压缩至“小时”甚至“分钟”级,代码层面的微创新和闭源防线在工业化的大模型算力面前被快速穿透;
- 从单一漏洞挖掘演进为全量克隆:REA 展现出的不仅是探查某处逻辑缺陷的能力,更具备将整个商业客户端功能模块、私有网络通信协议乃至数据解密密钥完整重构的能力。
代码本身的神圣感正在被迅速剥离,只要编译产物分发到用户端,其内部逻辑在 AI 眼前就几乎等同于单向透明。
连锁反应:黑灰产武器升级与移动端安全防御失效
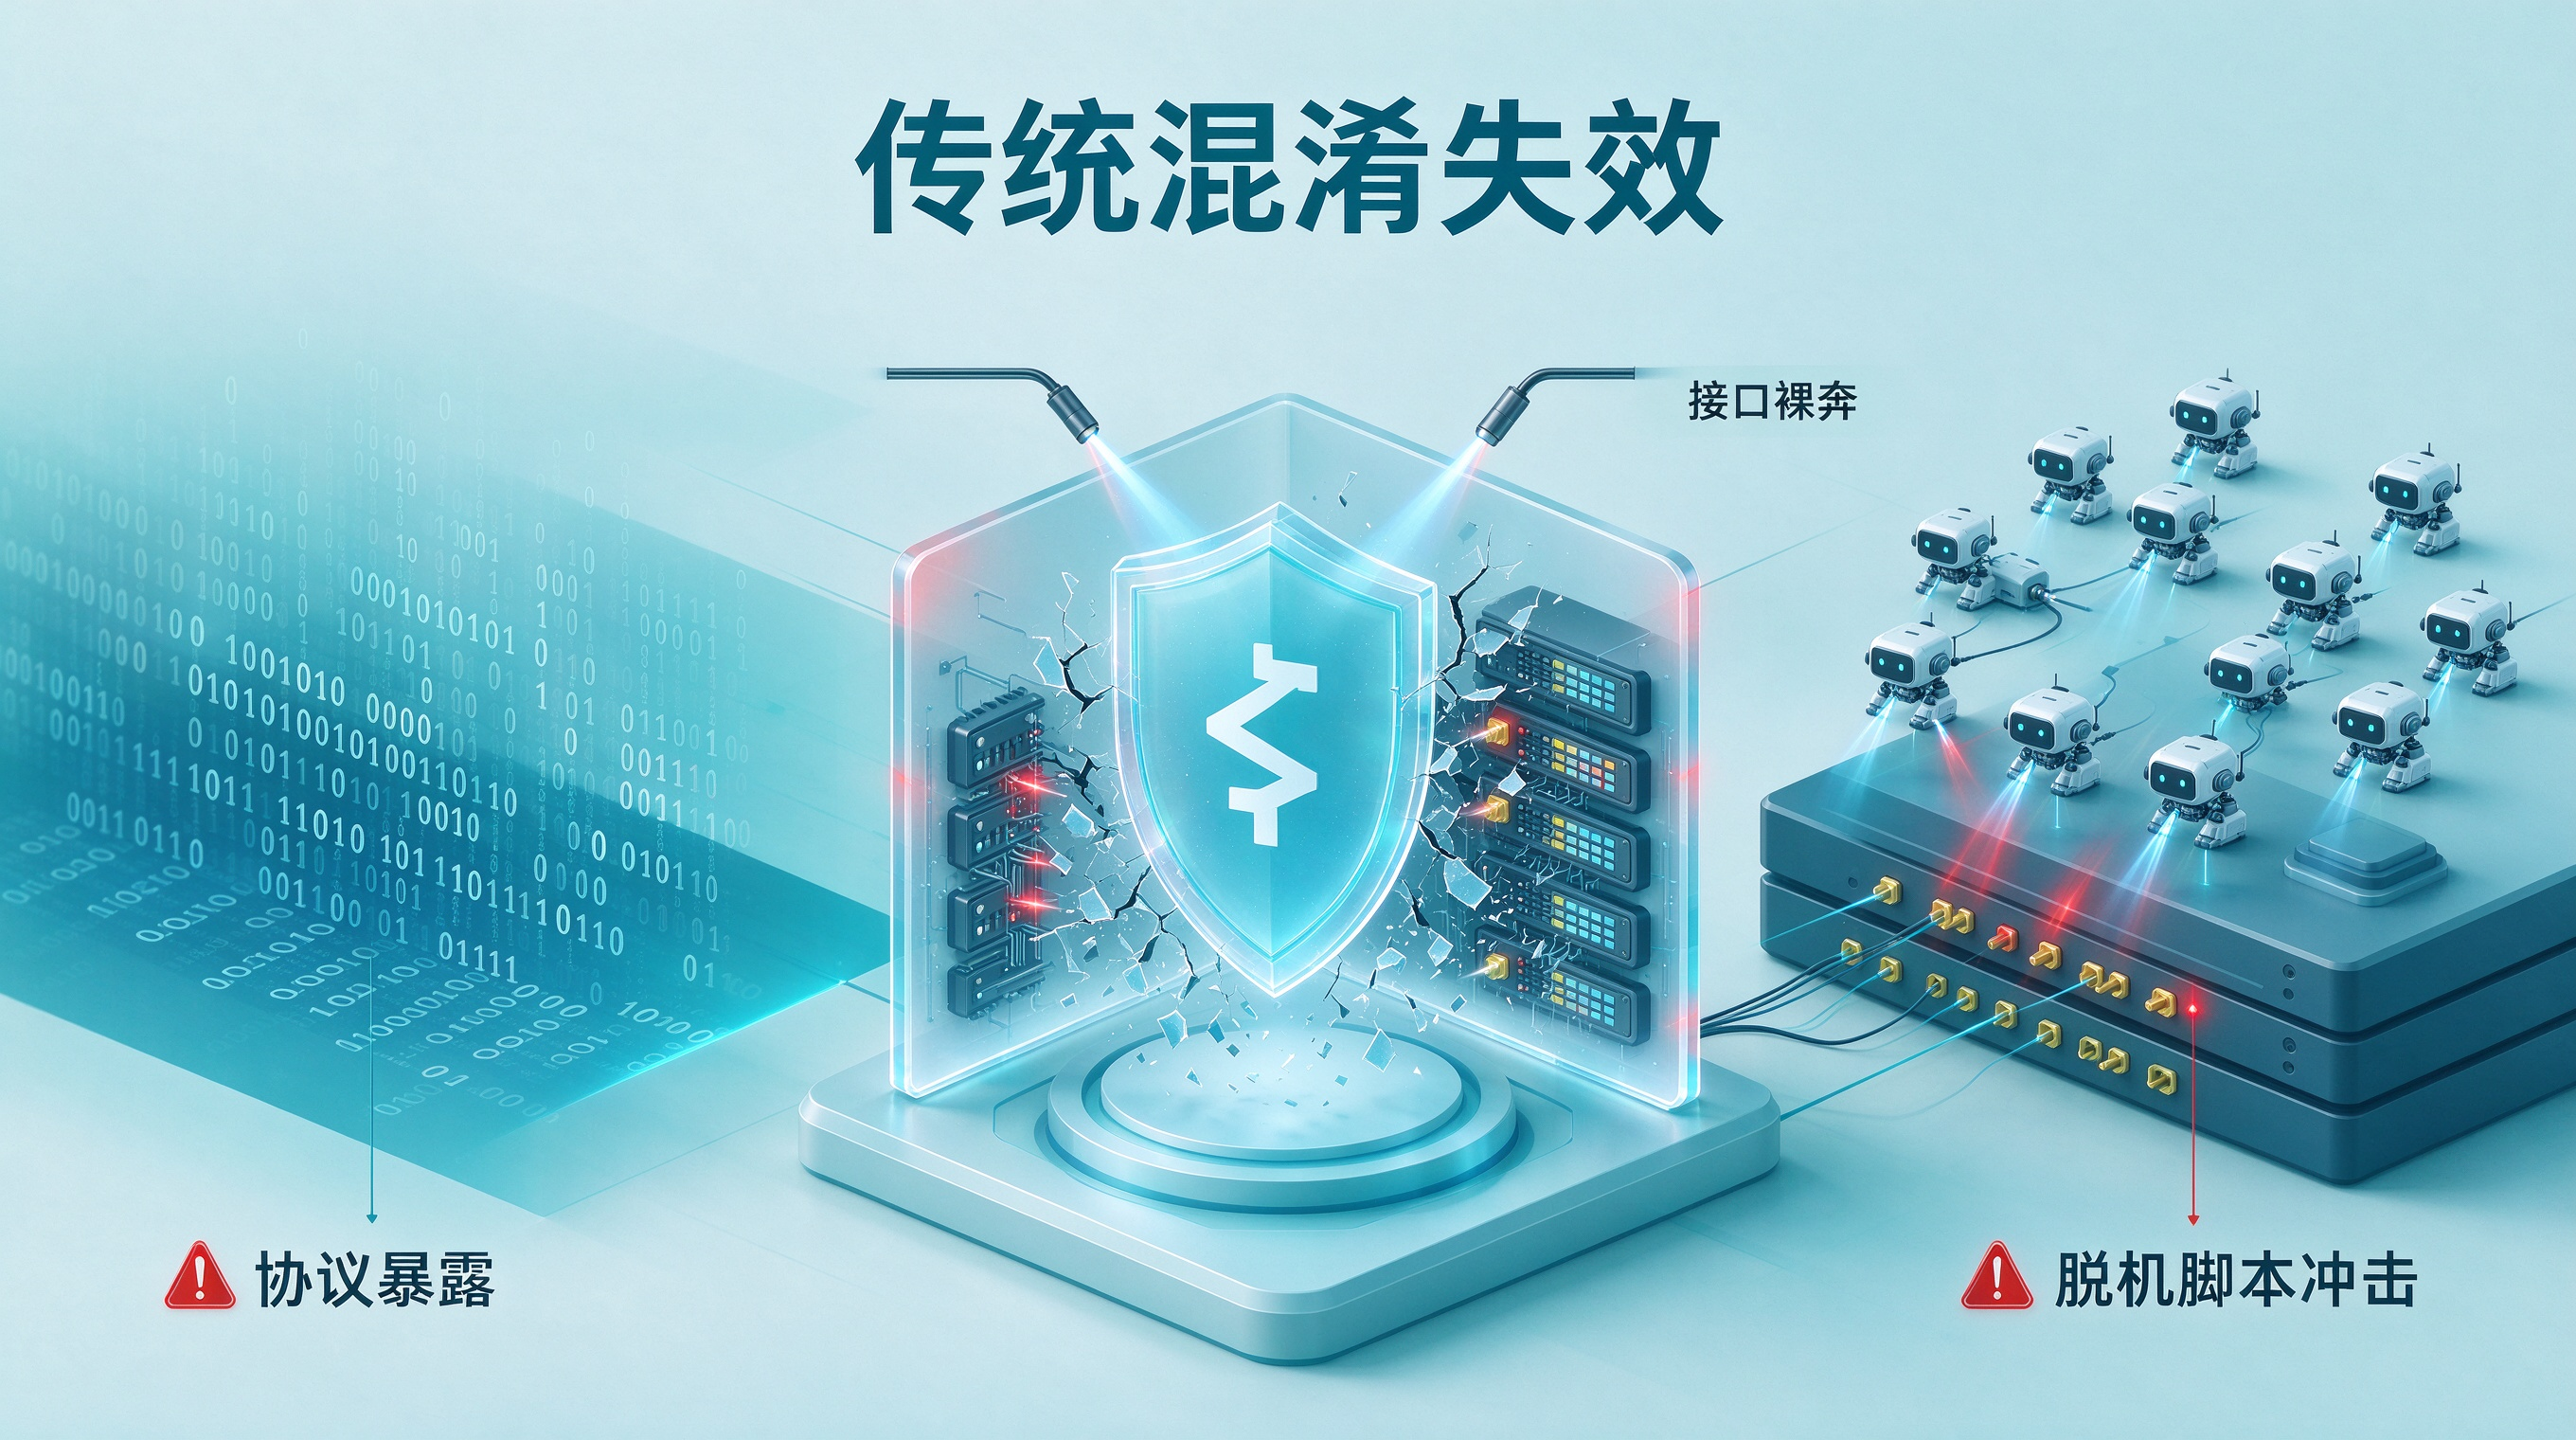
当 REA 这类工具在极客圈与开发者社群中以数万 Star 的速度裂变扩散时,最为敏感的并非正规软件企业的研发人员,而是长期潜伏在灰产链条上的逆向团伙。大模型赋能的逆向技术普及,直接引发了移动互联网生态在安全防御层面的剧烈震动。
以往移动应用在客户端构筑的风控与防作弊体系,很大程度上建立在“攻击者逆向成本高昂”这一经济学假设之上。一旦逆向成本趋近于零,原有的客户端防御阵地瞬间千疮百孔:
第一,核心业务协议与风控参数彻底暴露。绝大多数移动应用会将设备环境采集、参数签名算法(Sign)以及反抓取校验逻辑放置在原生动态链接库(.so 或 dylib)中,试图依靠 C/C++ 编译后的二进制形态抵御窥探。但在 REA 的自动化拆解下,签名计算中的加盐规则、混淆后的加密矩阵以及通信协议的序列化格式,都会被智能体迅速理清并输出为无混淆的逆向工程文档,导致后台接口直接裸奔。
第二,黑产自动化作弊与脱机挂泛滥成灾。过去黑客制作自动化刷单、抢券、刷量脚本时,需要手动逆向协议并在真机上挂载 Frida 或 Xposed 框架实施 Hook。如今,攻击者可以借助智能体自动逆向出的协议源码,直接在服务器端用 Python 或 Go 语言编写高度轻量化的“脱机客户端”,绕过整个图形界面和操作系统沙盒,对服务端发起高并发的虚假业务请求。
第三,代码二次打包与山寨仿冒呈爆发式增长。得益于大模型极强的代码转译与重构能力,逆向出来的代码经过变量重命名与架构调整后,能够以极低成本无缝嵌入到盗版或换皮应用中。这不仅导致软件开发者的商业机密失窃,更令原厂在知识产权维权时陷入取证与鉴定的法律泥潭。
工程破局:从代码混淆到深层设备指纹识别与端侧反作弊
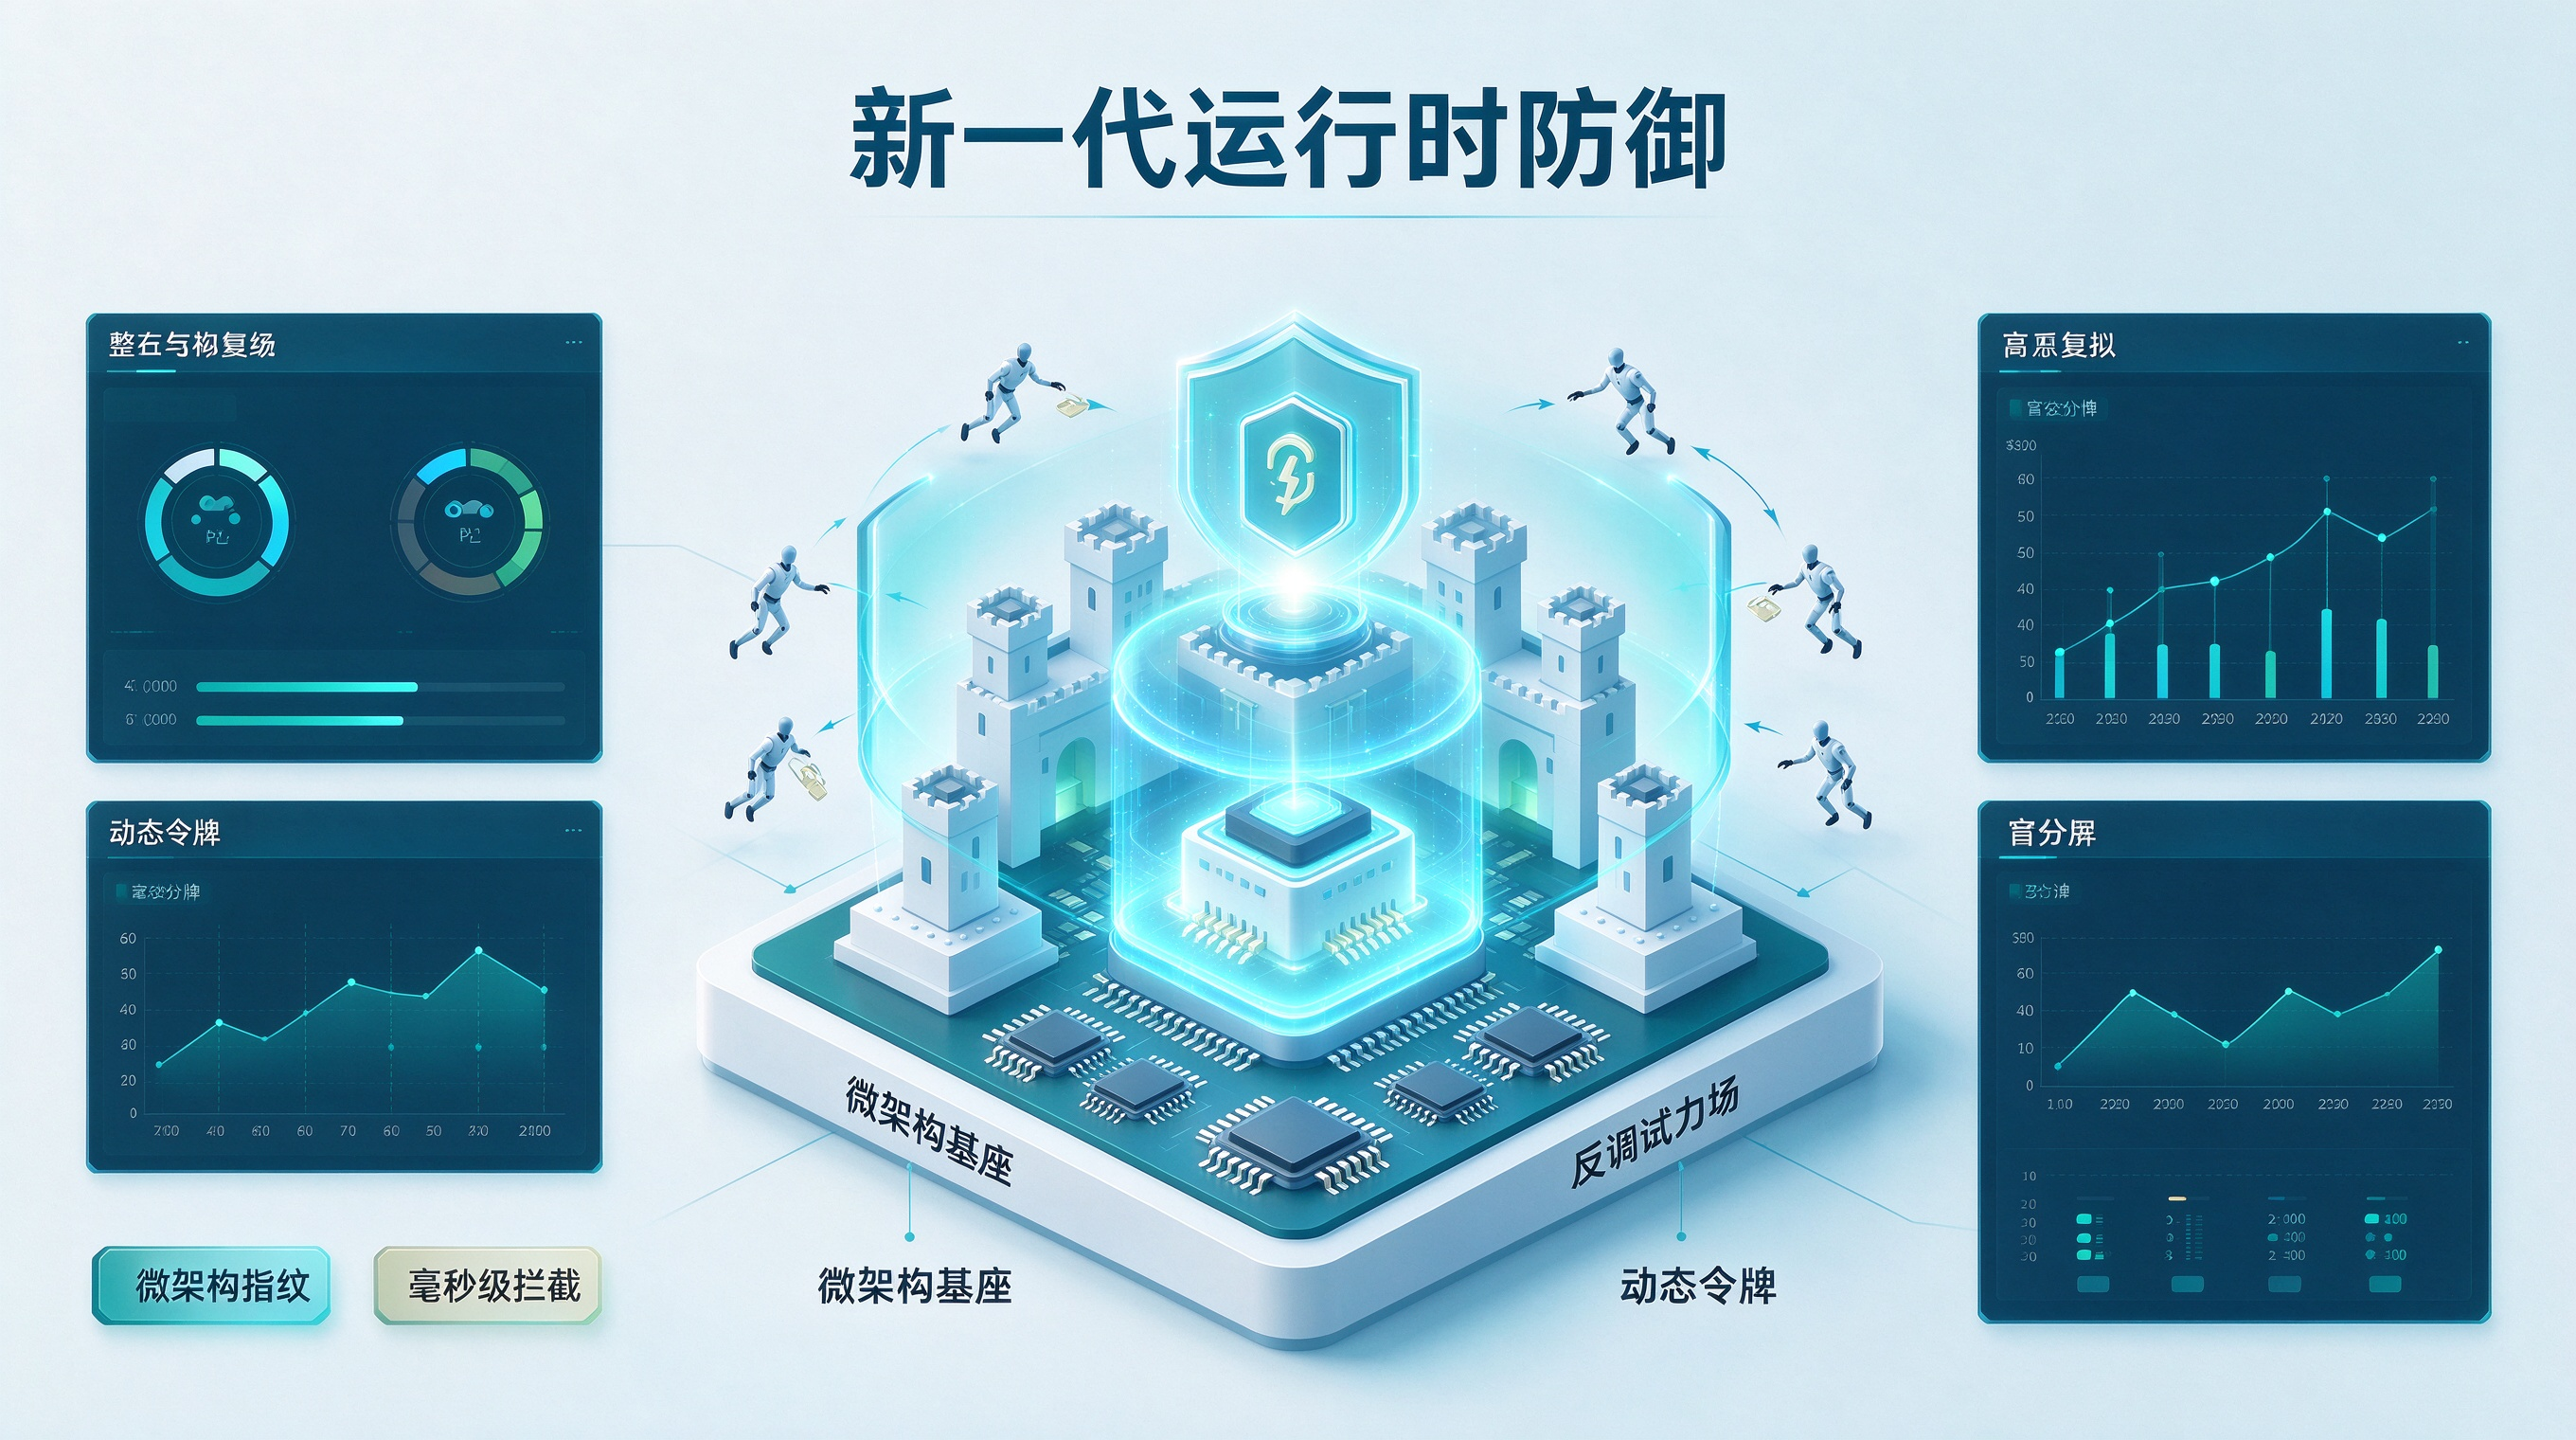
面对已经工业化、智能体化的逆向技术,单纯寄希望于加重代码混淆已无异于饮鸩止渴。将代码写成“人类与大模型都看不懂的乱麻”,不仅会极大牺牲客户端的执行性能、显著增加包体积,而且大模型在模式识别与上下文推理上的强大能力,迟早能在海量控制流扁平化与虚假控制流中理清主干脉络。
客户端安全架构必须经历范式转移:防御的重心不能仅仅停留在“防止代码被看懂”,而必须转移到“在运行时感知宿主环境的异动,并动态剥夺攻击者的伪造能力”。在移动分发生态中,软件开发团队需要从现代软件开发工具包的工程落地维度,构建覆盖运行期环境探测、设备多维特征校验以及行为信誉认证的立体防线。
[新一代移动端运行时防御与反作弊架构]
客户端启动与核心业务触发
↓
[底层动态反调试与代码完整性检测]
内核级监控 ptrace、内存补丁与动态 Hook 注入
↓
[微架构级设备指纹采集与特征聚合]
探查硬件微架构、底层驱动、系统底层文件与传感器噪声
↓
[防篡改算法生成高熵设备凭证]
结合服务端非对称加密下发的一次性动态盐完成数据签名
↓
[服务端风控中枢实时校验与信誉打分]
对比设备指纹历史行为,拦截模拟器、多开分身与协议脱机刷量
在实际技术选型与工程加固中,团队应重点推进以下防御策略:
1. 放弃静态对抗,构建微架构级设备指纹识别
无论逆向工具如何解析业务代码,其最终执行伪造请求时,都必须运行在某种计算载体之上——无论是云端虚拟机、自动化脚本集群,还是经过 Root / 越狱的调试真机。
- 传统的软性设备标识(如 IMEI、MAC 地址、Android ID 或 IDFA)极易被 Frida 插件或虚拟环境批量篡改,毫无防作弊公信力;
- 现代客户端安全必须下沉到底层硬件与系统内核,集成具备高防伪能力的设备指纹识别技术。通过采集 CPU 缓存架构微指令执行延时、底层渲染管道特征、传感器真实物理底噪以及系统底层驱动响应等数百维高熵物理指纹,并经由本地交叉校验算法,生成全局唯一且具备强反篡改能力的设备硬件凭证;
- 即使攻击者完全逆向了协议参数,只要其在云端模拟器或群控农场中回放请求,其设备指纹与底层物理环境的不匹配就会在毫秒内被风控中枢识别并拦截。
2. 运行时动态对抗与内核级反调试闭环
代码不能只是一堆静态的机器指令,而应具备自检与自我防御能力。在应用核心模块中,开发团队应部署内核级安全探针:
- 主动探查进程内存空间中的异常映射,实时感知 Frida、Substrate 等常见动态插桩框架的注入痕迹;
- 监控调试状态位与内核追踪信号(如 Linux 的
ptrace调用),一旦发现进程挂载调试器或处于内存断点单步调试状态,立即触发静默自毁或上报风控标记; - 实施代码段与只读数据段的内存动态哈希自校验,防范黑客在内存中直接下发补丁(Patch)篡改跳转分支。
3. 端云协同的动态签名与单次任务令牌
彻底摒弃客户端内置硬编码密钥或静态加盐逻辑的传统做法:
- 核心业务接口的签名凭证,必须依托端云握手协议进行动态生成。服务端在下发任务时,实时分发包含时效戳与不可预测伪随机熵的单次动态 Token;
- 客户端在调用关键服务前,必须调用本地安全模块结合当前时刻的设备环境指纹、系统运行状态与动态 Token,在安全内存区(Secure Enclave / TEE)完成加密计算;
- 服务端只接受携带有效设备指纹凭证且时效窗口未过期的合法请求,杜绝了攻击者抓包后无限次脱机重放或离线批量构造报文的可能。
4. 规范渠道安装溯源与转化链条审计
在防范黑客逆向技术渗透到渠道作弊与虚假获客方面,应用团队需要对用户的安装来源实施全流程可信溯源:
- 借助安装推荐接口与规范的应用意图(App Intents)调度协议,在保护用户隐私的前提下,对真实自然安装、应用商店分发与外部深度链接跳转建立完整的设备级归因指纹闭环;
- 针对黑产利用逆向工具批量解包重签名、篡改渠道 Channel ID 的恶性竞争行为,通过全渠道校验与端侧签名多点核对,确保每一笔转化数据与激活行为真实可信,切断黑产依靠逆向工具实施流量欺诈的变现路径。
未来生态:告别虚妄的安全感,筑牢动态风控底座
逆向工具 REA 的爆发并非一场偶发的技术狂欢,而是大语言模型深入底层二进制领域后引发的必然裂变。它无情地戳破了软件行业过去数十年间建立在“代码晦涩性”之上的虚假安全感。
在智能体触手可及的全新纪元,开发者必须认清技术演进的客观规律:
- 静态的二进制代码不再具备长期保密性。试图通过更晦涩的混淆语法、更奇诡的代码逻辑来阻挡 AI 逆向,在经济账上完全无法持续;
- 真正的安全护城河建立在动态的防御体系之中。这包括对底层物理环境的精准感知、毫秒级响应的设备指纹核验、端云一体的动态授权机制,以及对业务异常行为的实时流式计算拦截;
- 善用成熟可靠的基础设施服务。面对日新月异的自动化逆向威胁,中小型开发团队往往难以独立承担高强度的底层攻防对抗成本,及时接入经过海量黑灰产实战洗礼的专业安全 SDK 与反作弊系统,将精力聚焦于核心业务创新,才是抵御技术风暴的最优解。
常见问题(FAQ)
REA 这类 AI 逆向工具与传统的 IDA Pro 或 Ghidra 有什么根本区别?
IDA Pro 和 Ghidra 是传统的逆向分析套件,依赖人类逆向工程师手动阅读反汇编指令、识别函数逻辑与跟踪调用链,对操作者的专业技能要求极高。而 REA 借助 MCP 协议将反编译能力封装为大模型的标准化工具,使 Claude Code 或 Codex 等智能体能够自主调度反编译引擎、阅读控制流并直接输出高可读性的源码重构,将人工分析过程自动化。
为什么仅仅增加代码混淆无法有效抵御 AI 驱动的逆向工程?
传统代码混淆主要通过扁平化控制流、插入虚假指令或加密字符串来增加人类阅读的认知负荷。然而,具备超长上下文与深层模式识别能力的 AI 智能体,能够高效分析上万行混乱指令之间的数据依赖与函数拓扑关系,过滤无用垃圾指令并还原核心算法逻辑。同时,过度混淆还会严重拖慢应用运行效率并增大安装包体积。
客户端在遭遇高阶逆向破解时,设备指纹识别为什么能发挥关键作用?
即便黑客逆向了应用的业务协议或反编译了核心算法,其为了实现批量获利,通常必须将攻击逻辑部署在虚拟化环境、自动化云手机或群控设备中批量运行。深层设备指纹识别深入硬件微架构与系统内核层,能够精准识别模拟器、调试容器、Root 越狱设备以及 Hook 注入环境,从而在服务端直接拒绝异常环境发起的请求。
采用标准 SDK 进行端侧安全加固会影响应用的运行性能吗?
规范的安全与分发 SDK 通常采用模块化与异步加载机制,将高耗时的环境检测与特征哈希放在后台工作线程或核心业务事件触发时进行。同时,核心对抗逻辑大量采用原生轻量级系统调用,在确保毫秒级响应与低内存占用的同时,不会对用户界面的前台流畅度造成负面影响。
面对越来越强大的自动化逆向工具,应用开发者当前最紧迫的防御动作是什么?
开发者首要的任务是审计客户端暴露的静态资产与接口调用方式:立刻下线硬编码在客户端内的静态加盐与高权限密钥,将敏感业务逻辑收拢至服务端校验;同时,在移动端底层接入高强度的设备指纹采集与运行时完整性自校验组件,建立端云协同的动态风控防线,防止黑灰产通过自动化脱机脚本批量侵害业务资产。