App 下载量 VS 安装量 VS 激活量怎么区分?Open+ 构建多维度评估体系全链路解析
 openinstall运营团队|
 2026-11-03|
 326
当增长团队在评估渠道质量时面临"下载量、安装量、激活量口径混乱、高激活零付费、LTV 预测失真"等行业顽疾时,如何彻底摒弃传统"只看新增、单一指标导向、缺乏全链路归因"的粗放模式,利用 Open+ 广告监测能力 构建一套涵盖"下载量、安装量、激活量、留存衰减、LTV 测算、动态权重分配"的多维度评估体系,将整体投放 ROI 硬核拉升至 24.6% 的工业级可用性巅峰,彻底打破"高激活、零付费"的买量陷阱? 核心答案是:必须将渠道评估从"只看新增、单一指标导向"升级为"下载量、安装量、激活量、留存衰减、LTV 测算、动态权重分配"的多维度评估体系。首先通过全链路归因底座(设备指纹快照 + 深度行为事件上报 + 流批结合计算引擎),打通从点击、安装到后端变现的数据经脉;随后利用留存衰减模型与 LTV 预测算法(指数衰减曲线 + ARPU 加权求和),精准甄别"高激活、零付费"的劣质流量;最后通过多维质量评分公式(Q-Score)的动态权重分配,实现劣质流量的果断剥离与优质渠道的预算加码。传统粗放模式由于缺乏全链路归因能力,往往陷入"高激活、零付费"的预算黑洞;而现代多维度评估体系能够系统化还原每一笔流量的物理因果,将整体投放 ROI 提升 24.6%,确保每一分营销预算都流向真实的商业价值闭环。
物理断层与行业痛点
"只看新增"的虚假繁荣与预算黑洞
在移动营销的早期阶段,企业普遍采用 CPI(按安装付费)或浅层 CPA(按激活/注册付费)作为媒介采买的唯一考核指标。然而,随着流量红利的见顶与渠道内卷的加剧,这种"只看新增"的粗放模式已彻底沦为吞噬利润的预算黑洞:
- 劣质流量的"高激活、零付费"陷阱:当优化师和媒介团队的 KPI 仅仅与前端激活量挂钩时,他们会本能地将预算倾斜给那些看似单价极低的长尾网盟或积分墙渠道。这些渠道往往充斥着为了赚取微薄佣金而下载 App 的"网赚羊毛党",甚至是精心伪装的云控机器脚本。
- 跨渠道数据孤岛:前端消耗与后端变现的裂解:各广告平台的前端后台,只清楚自己投放了多少曝光预算、带来了多少次表层激活,由于受限于应用沙盒隔离,它们对用户随后在 App 内的停留时长、购买频次一无所知;而企业内部的业务数据库(BI 或订单数仓)虽然能精确记录每天有多少活跃用户产生了多少充值流水,却因为缺乏底层的设备物理探针与归因映射表,极难将这笔具体的充值金额,精准回溯并挂载到 30 天前用户点击的某一条特定广告计划上。
- 确立多维度评估新范式:依托类似 Open+ 这样具备全链路时序追踪与深度事件映射能力的归因中台,增长团队可以彻底打通从点击、安装到后端变现的数据经脉,配合 渠道质量评估怎么做?结合安装留存付费构建多维评分模型 实现劣质流量的果断剥离与优质渠道的预算加码。
下载量、安装量、激活量的底层差异与漏斗断层
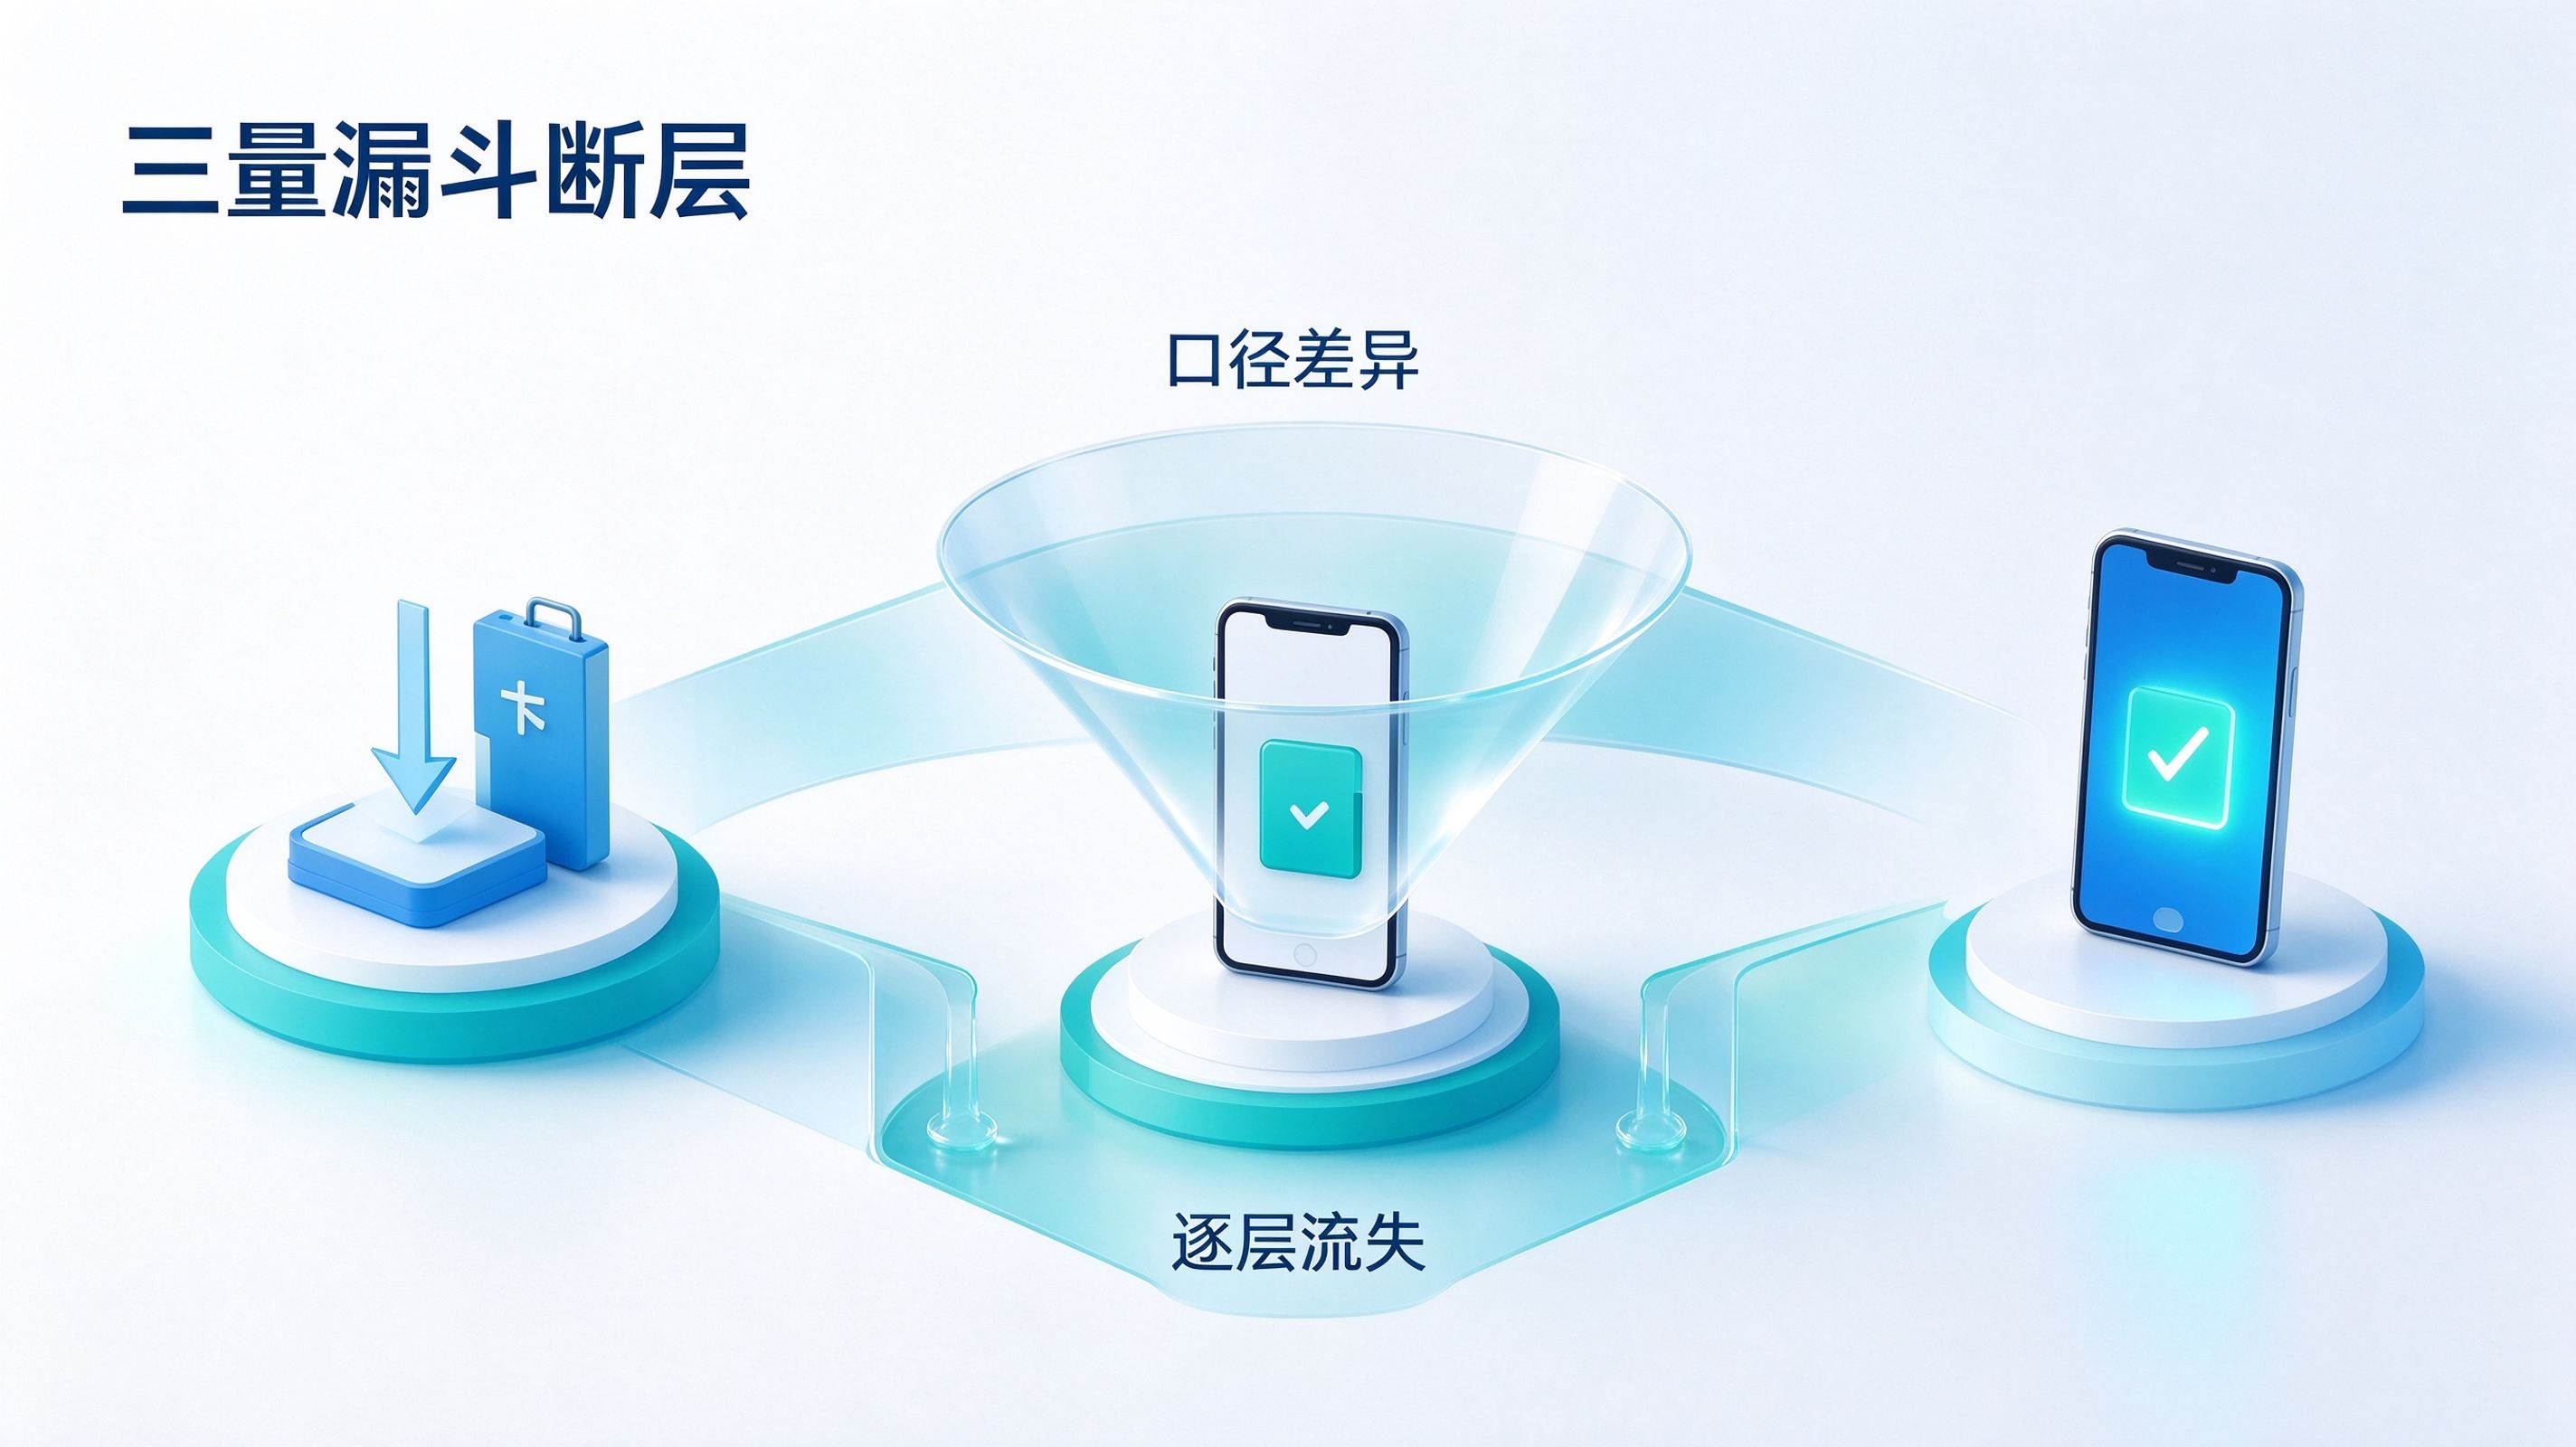
许多看似神秘的"数据蒸发"与"预算失血",其底层实际上是不同系统在工程实现上的物理时空断层所导致的假象:
- 下载量(Downloads):应用商店(App Store / Google Play)统计的是安装包被下载写入存储介质的动作次数,包括"下载后未打开"的用户流失。
- 安装量(Installs):应用商店统计的是安装包完成安装写入存储介质的动作次数,包括"安装后未打开"的用户流失。
- 激活量(Activations):第三方归因中台与 BI 统计的是安装后首次冷启动并上报网络事件的次数,忽略"下载后未打开"的用户流失会导致 8% 到 20% 的天然落差。
- 确立多维度评估新范式:通过统一时钟基准与解耦时间戳记账逻辑,配合 追踪 App 安装渠道方法:多维度数据对账与流量排障方案 彻底剔除因口径错位造成的假性偏差。
底层原理与数据管线拆解
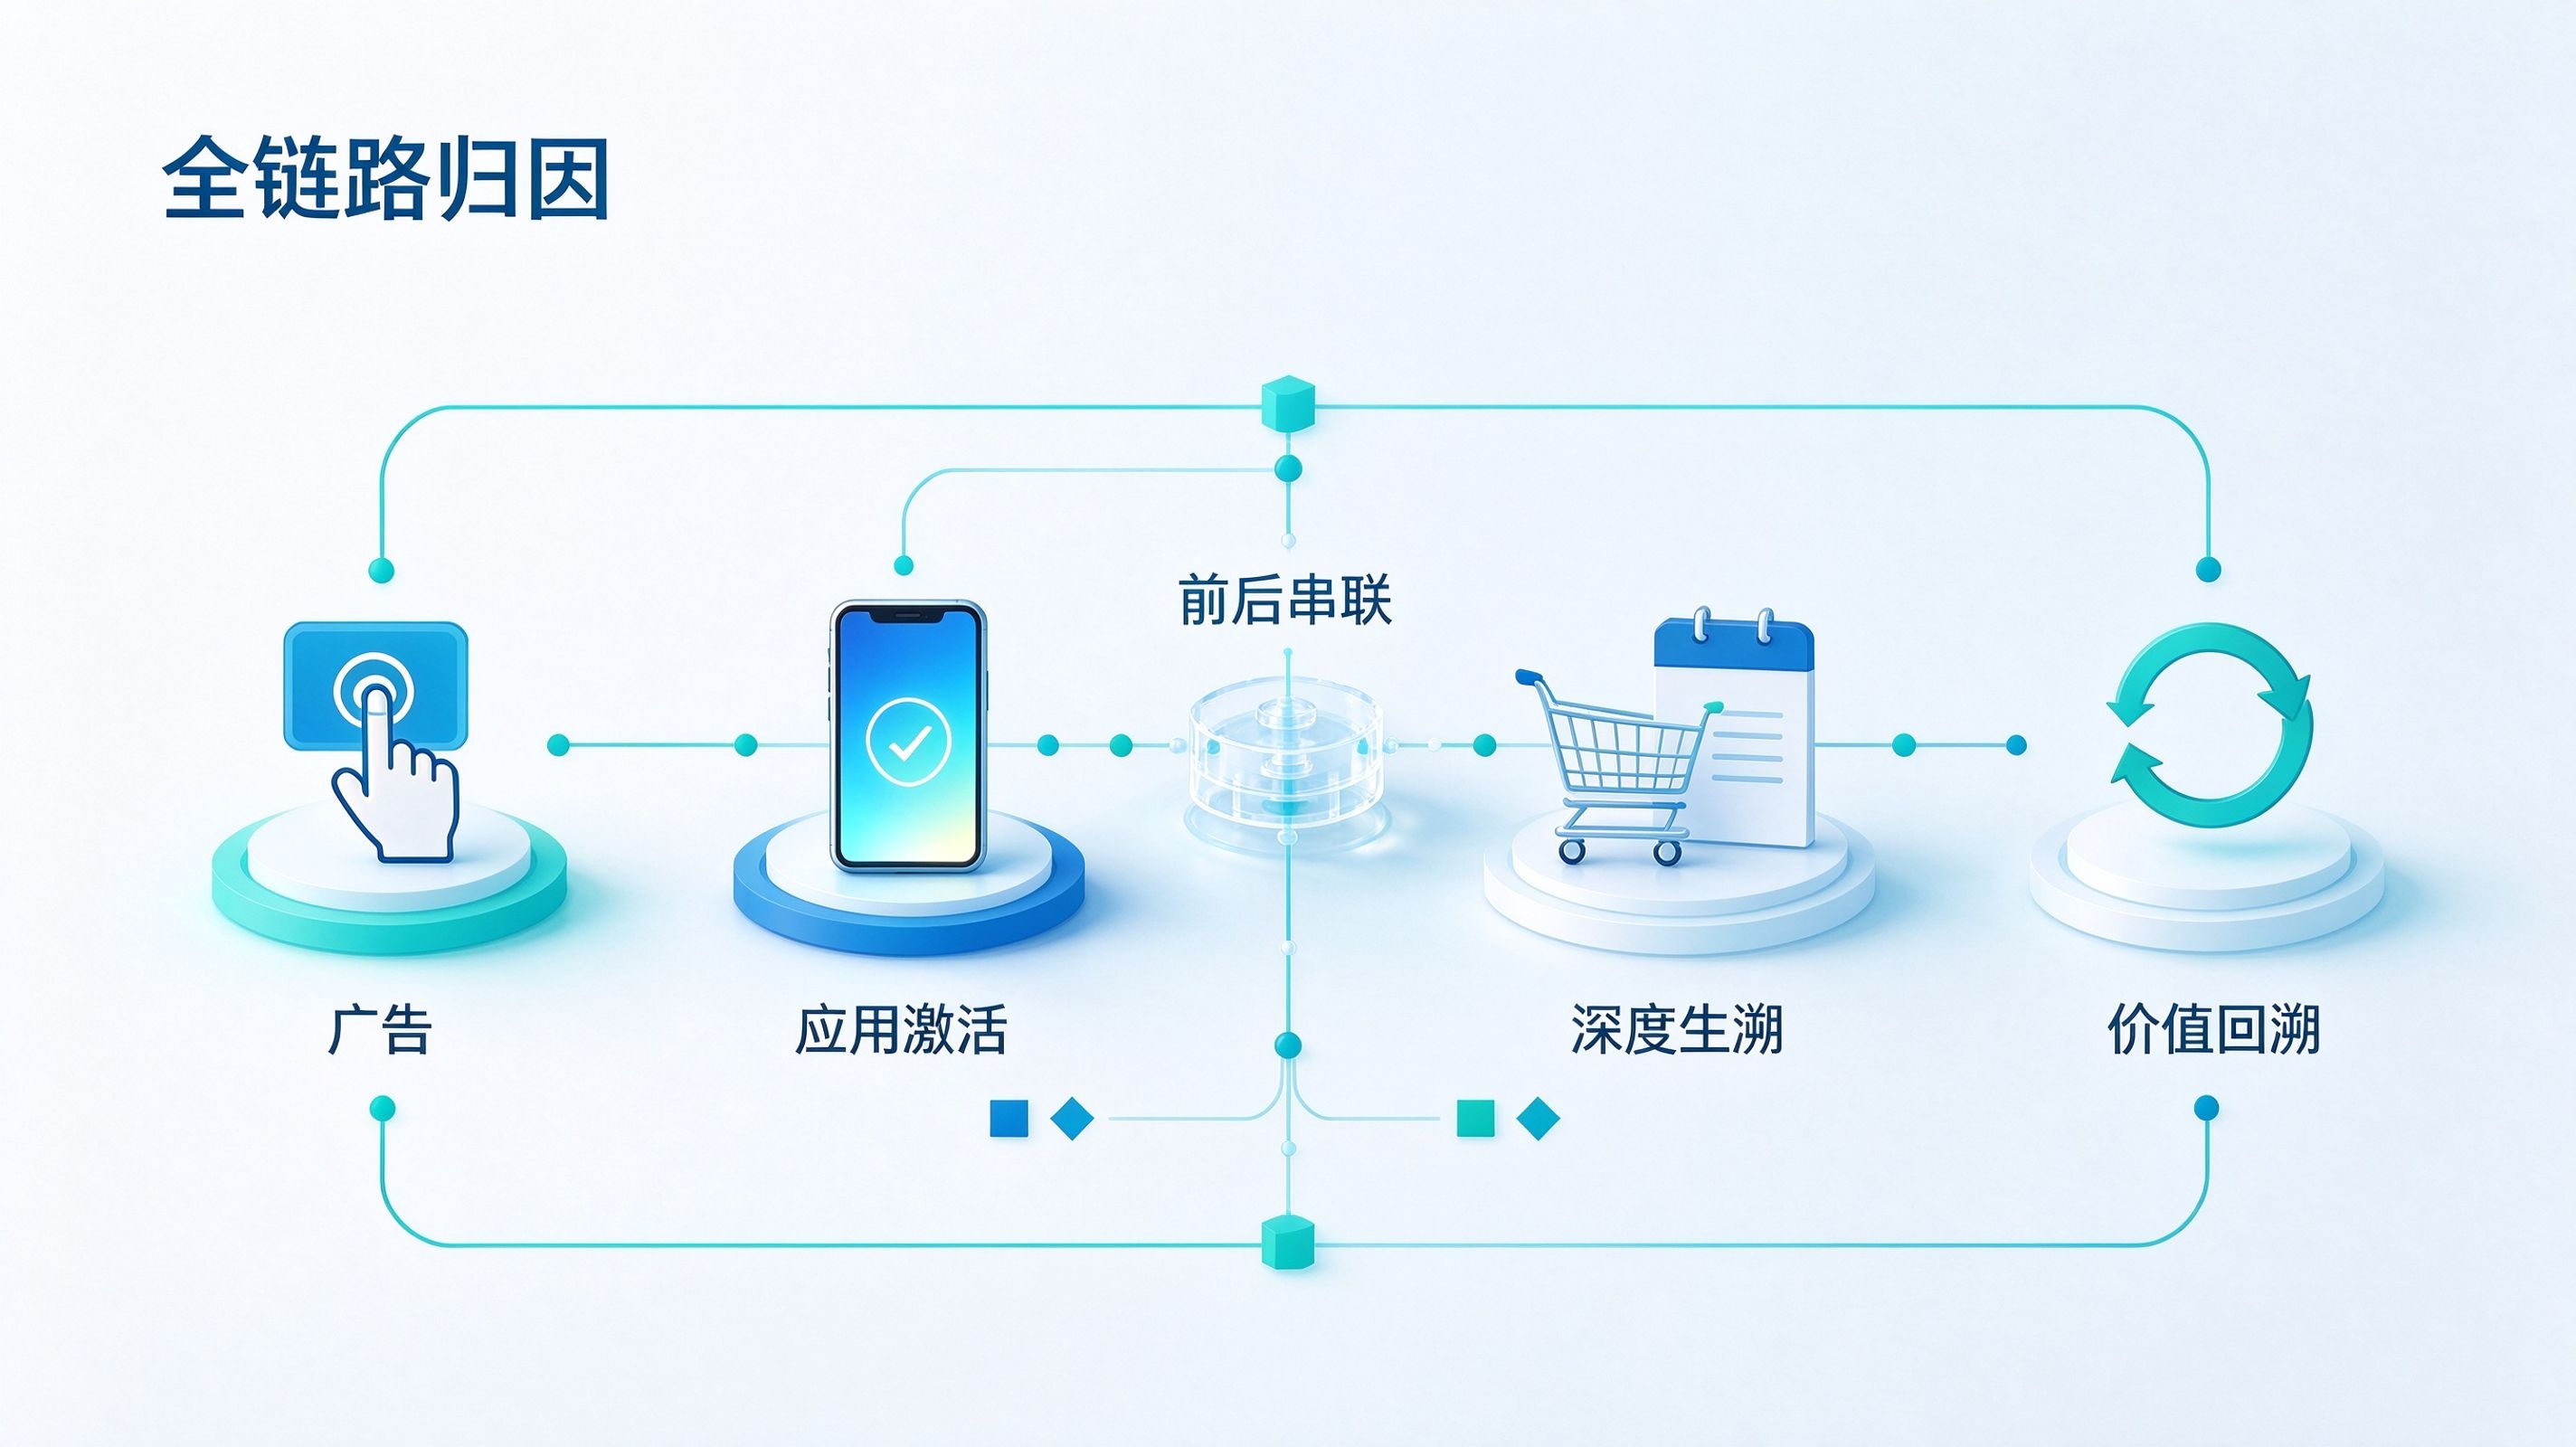
事件追踪与特征串联:打破前后端数据孤岛
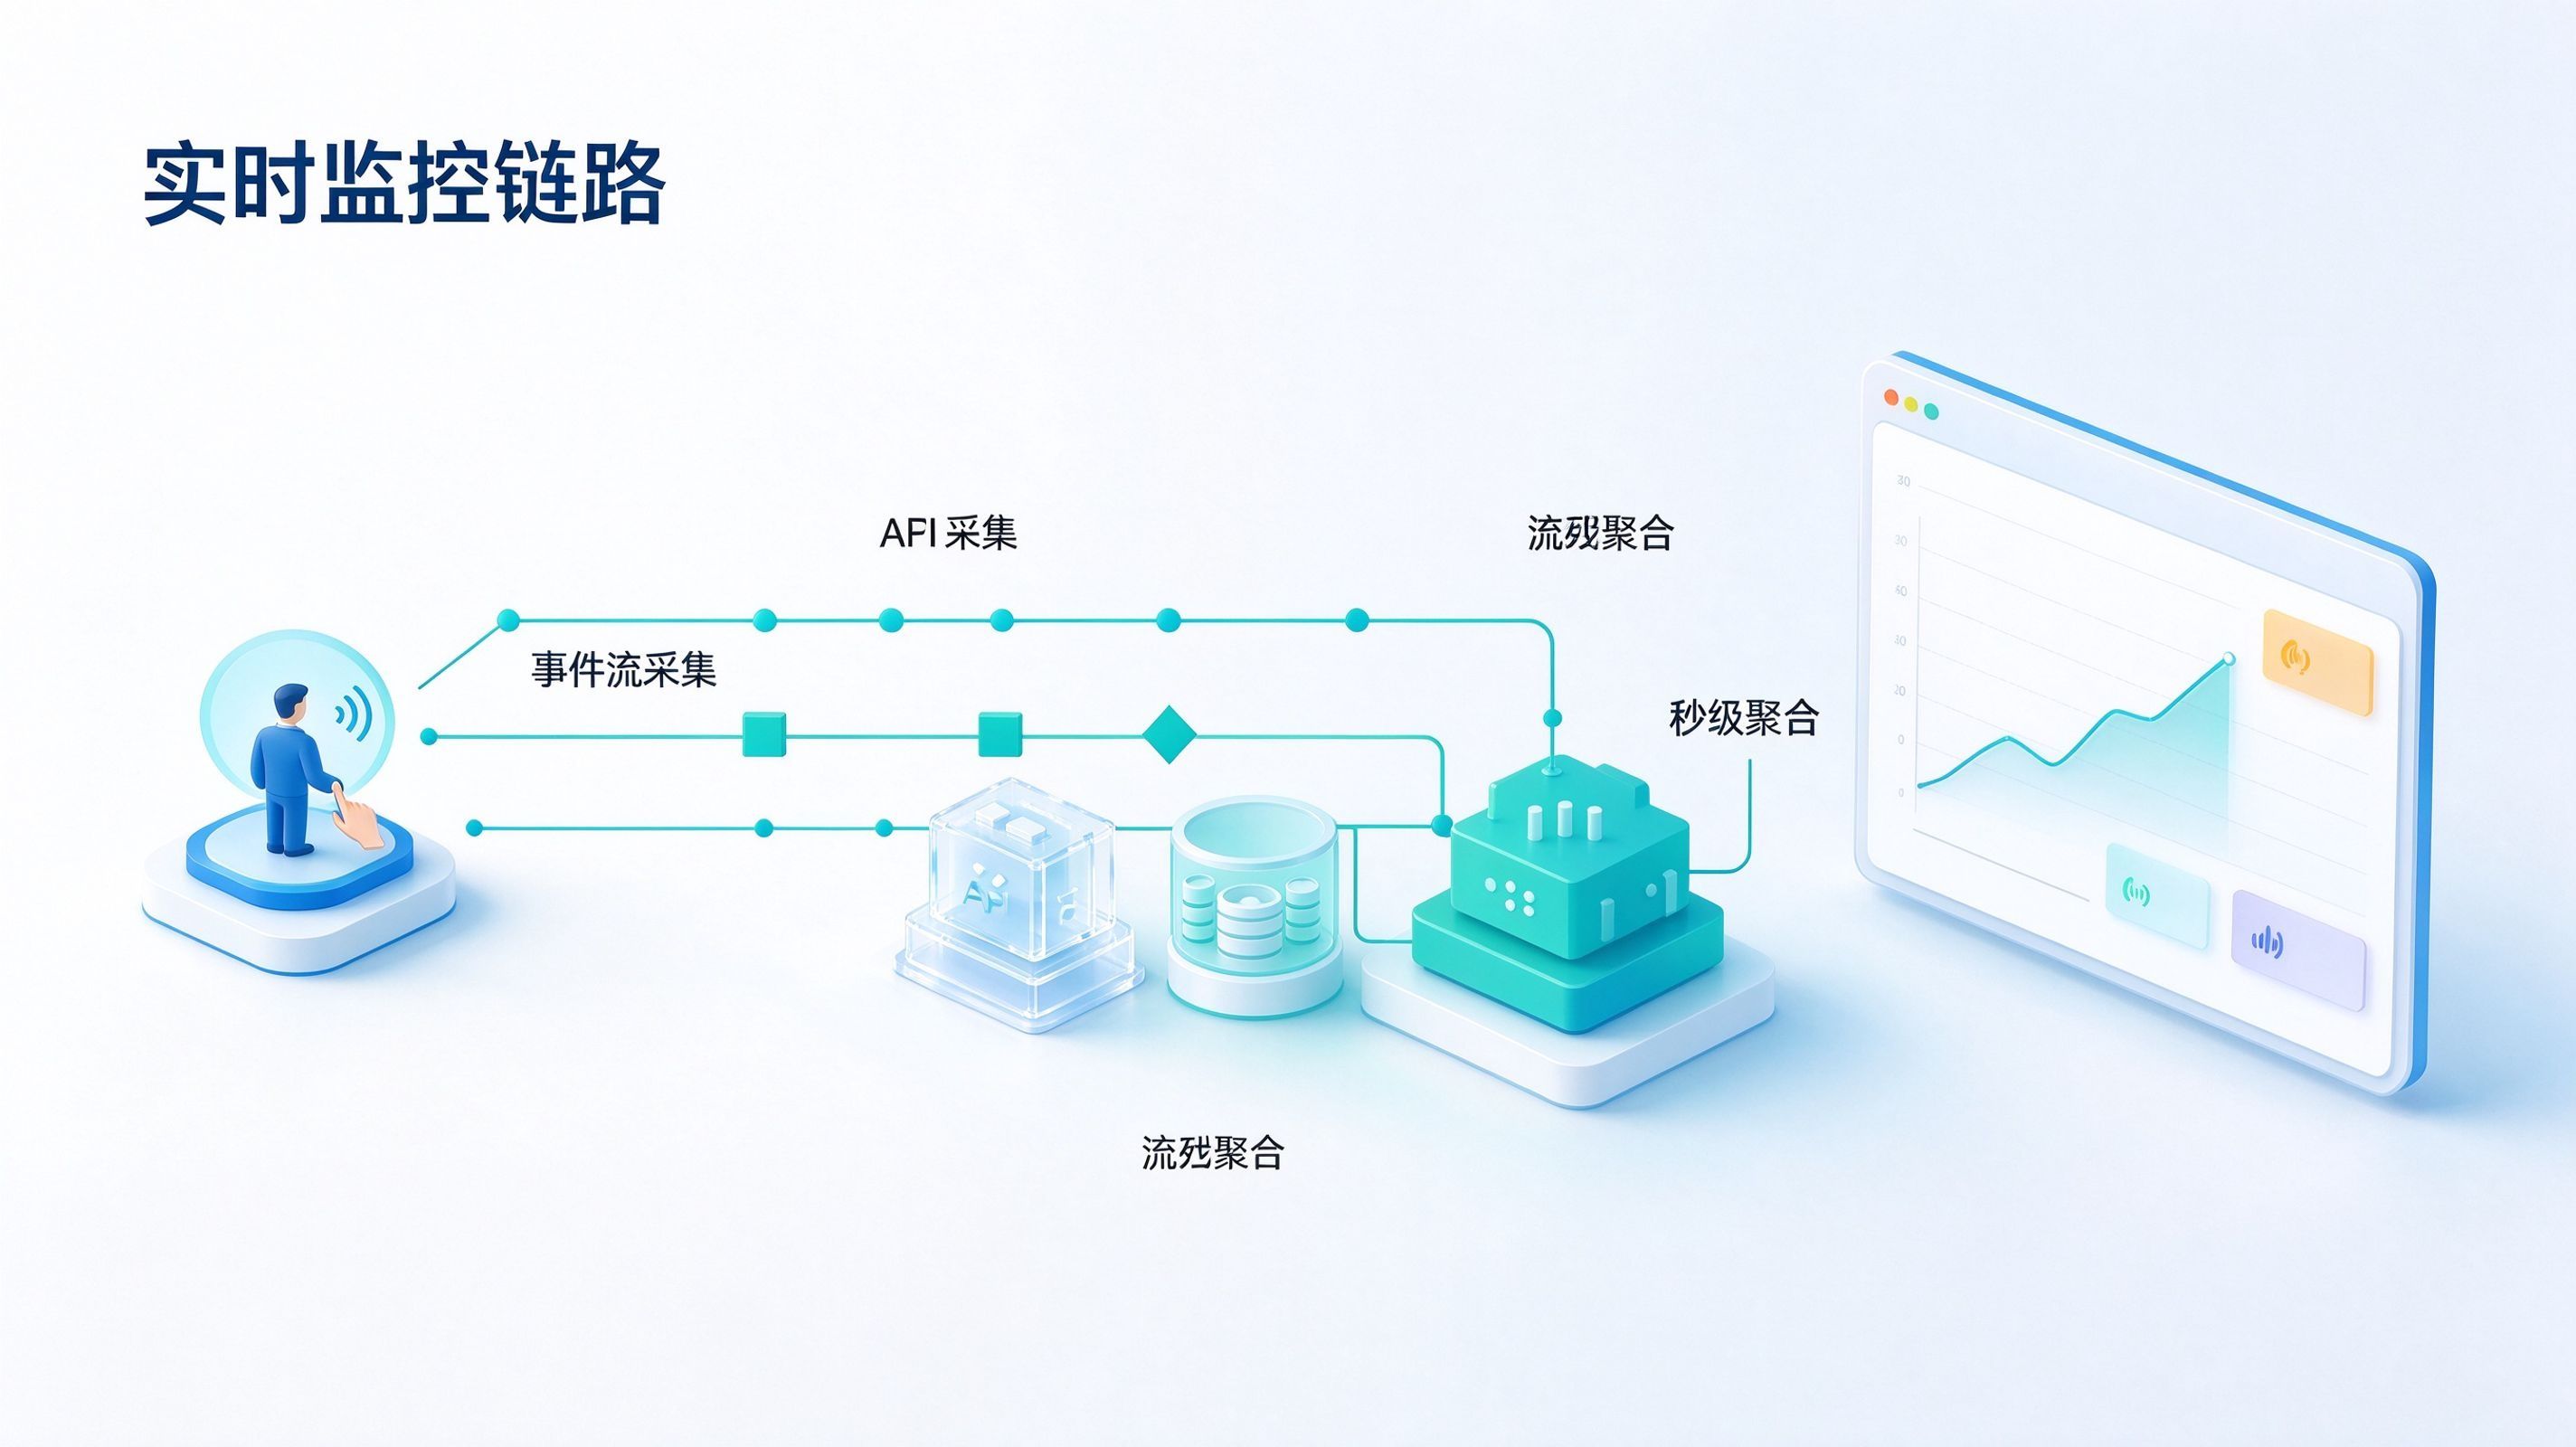
构建多维评分模型的基础,在于建立一条不容篡改的全链路归因管线:
- 步骤一:前端预埋与设备特征快照:当用户点击广告并首次下载打开 App 时,归因中台探针会实时提取设备的硬件级快照特征,包括不限于 IP 地址、操作系统微版本号、User-Agent 字符串、设备屏幕分辨率以及存储容量、电池状态等细分维度。
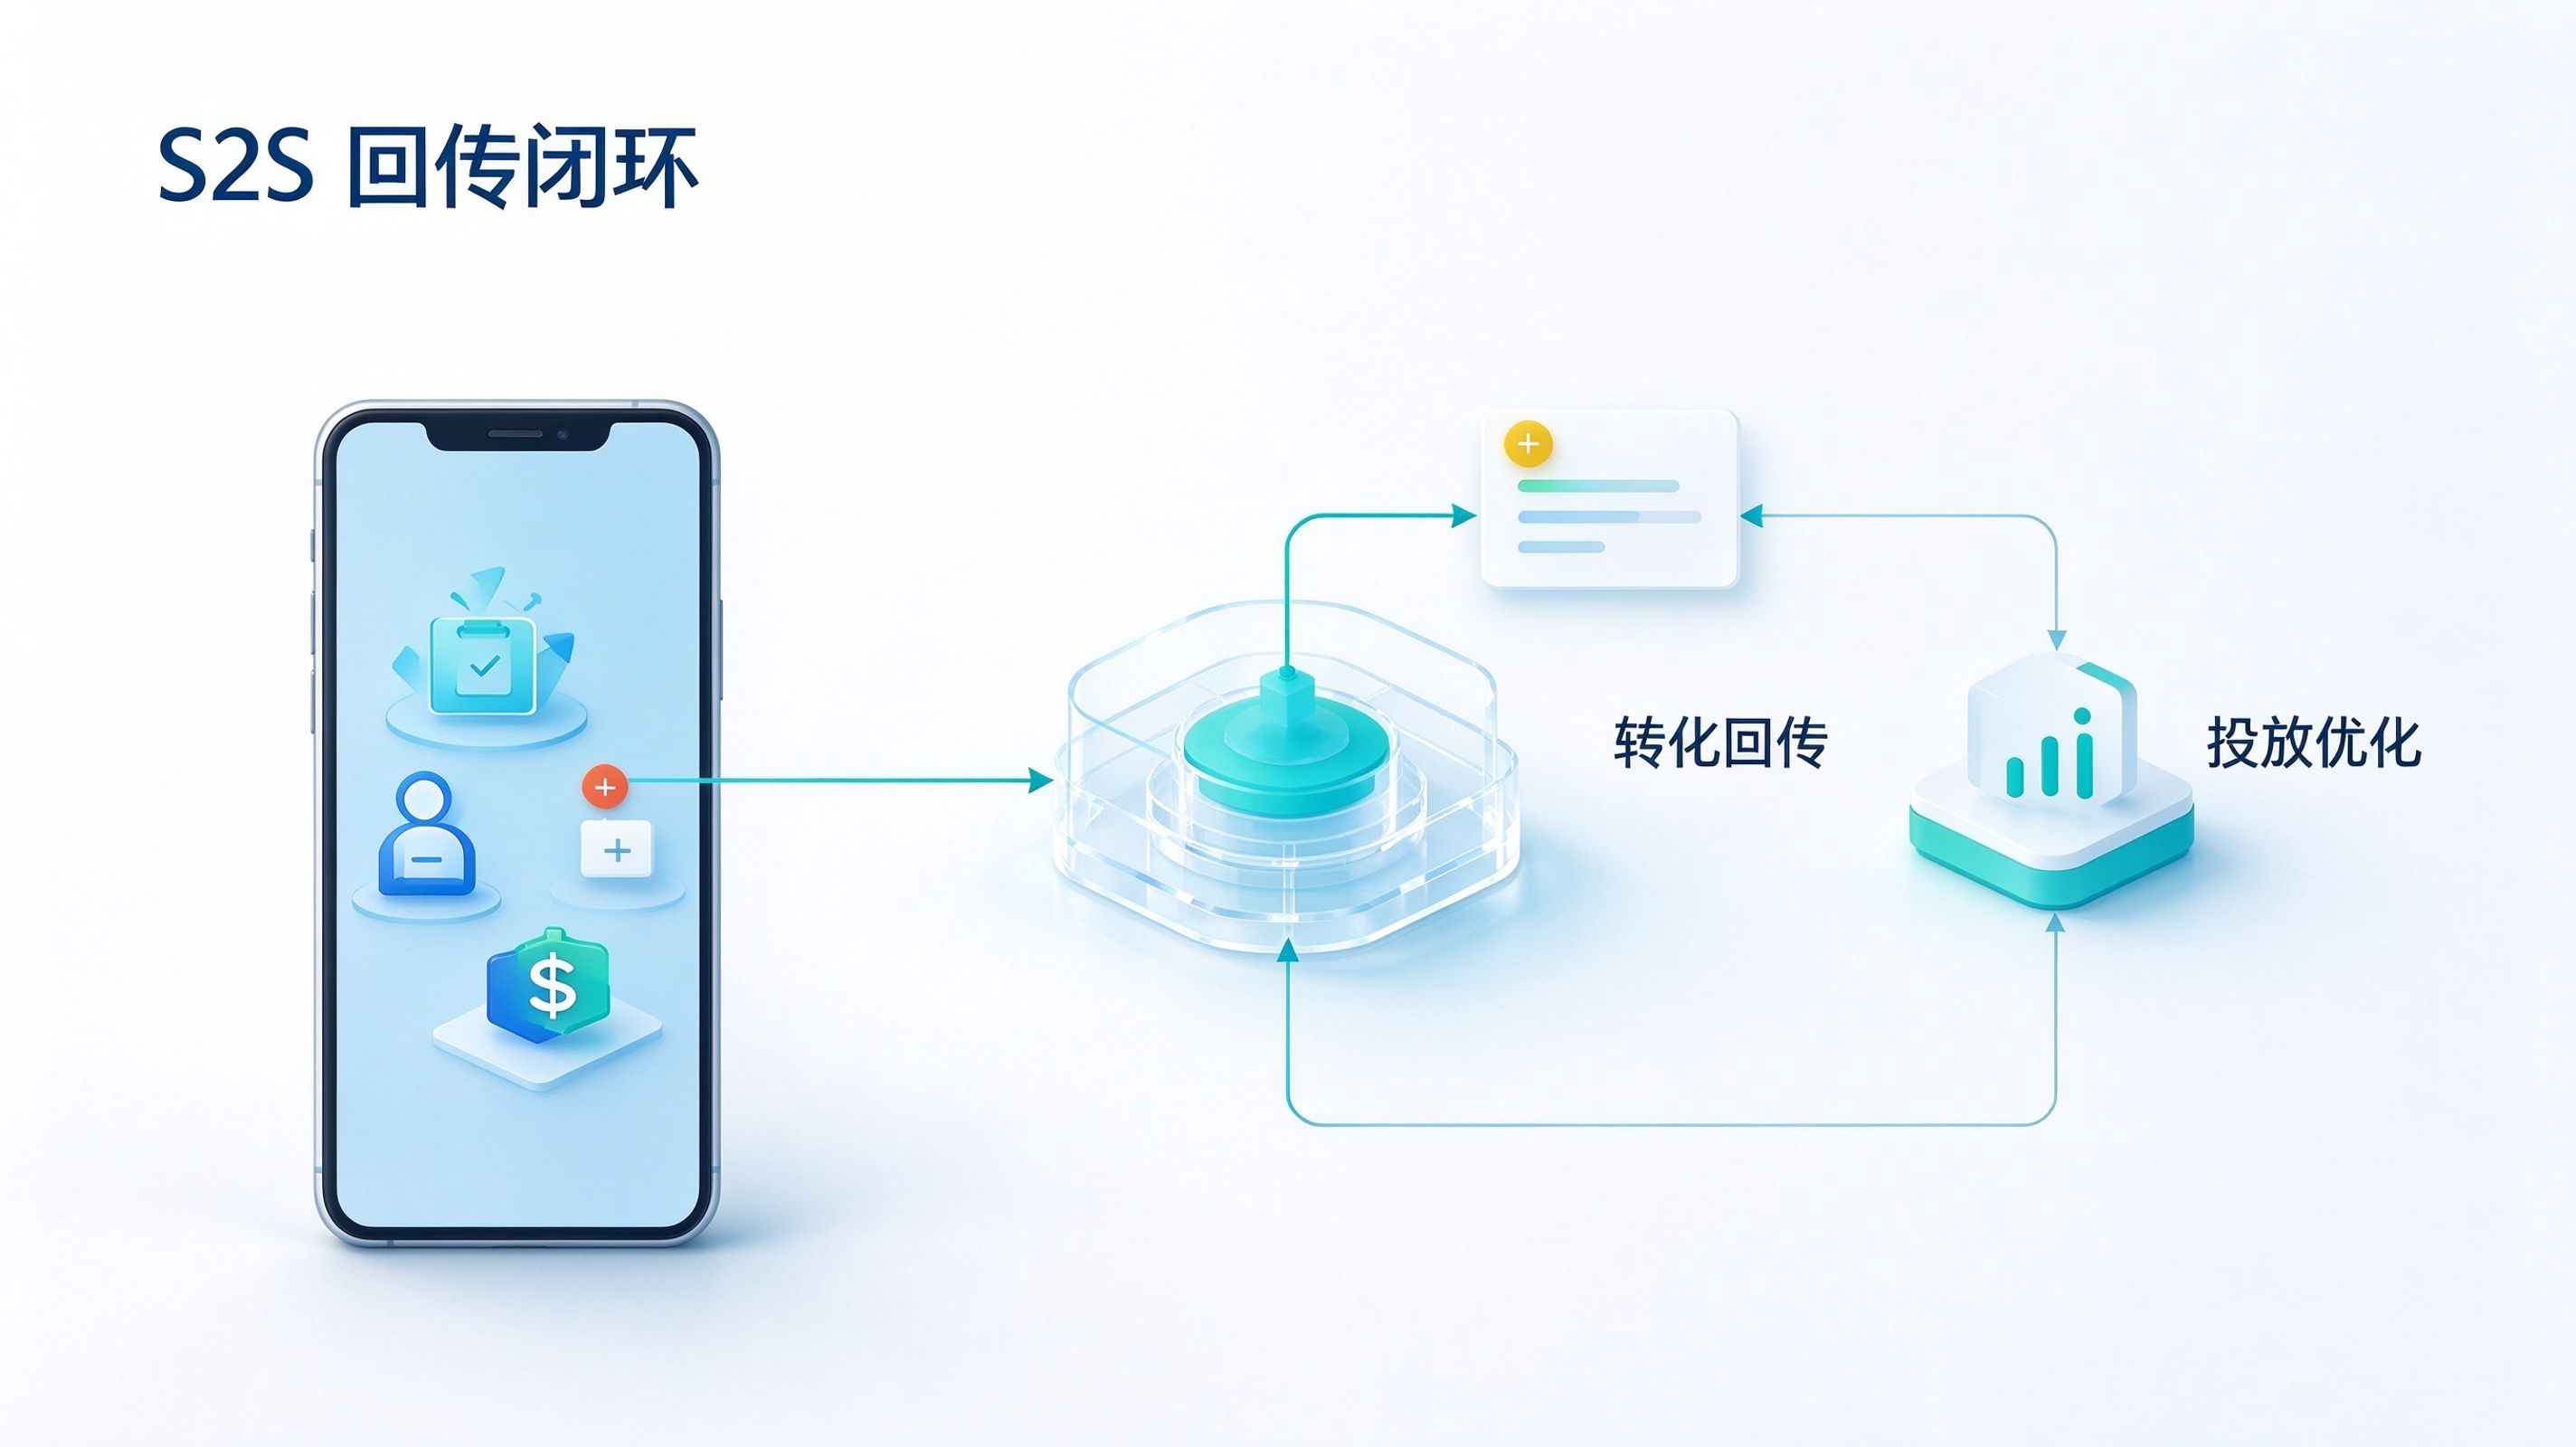
- 步骤二:深度行为事件上报:随着用户生命周期的展开,当该用户在 App 内触发高商业价值的深度行为(如"次日打开"、“完成实名认证”、“首次购买月卡”、“高频复购”)时,埋点 SDK 会将这些深度事件(Events)以及对应的金额价值(Values)连同设备 ID 一起上报。
- 步骤三:流批结合计算引擎关联:中台的流批结合计算引擎执行关联操作,将这些后置的转化价值,精准回溯并累加到其初始绑定的渠道上。
[ 用户点击广告 ] ──> [ Open+ 归因中台提取设备特征快照 ]
                                              │
                                              ▼
                                 [ 应用商店完成安装包下载(Downloads) ]
                                              │
                                              ▼
                                 [ 安装包完成安装(Installs) ]
                                              │
                                              ▼
                                 [ 用户首次冷启动 App(Activations) ]
                                              │
                                              ▼
                                 [ SDK 上报设备指纹至云端 ]
                                              │
                                              ▼
                                 [ Open+ 归因中台完成点击 - 激活匹配 ]
                                              │
                                              ▼
                                 [ 用户触发深度行为事件(注册、付费、留存) ]
                                              │
                                              ▼
                                 [ 流批结合计算引擎关联回溯至初始渠道 ]
                                              │
                                              ▼
                                 [ 多维评分模型动态权重分配 ]
                                              │
                                              ▼
                                 [ 渠道质量评分(Q-Score)输出 ]
三大核心维度提取:安装、留存与 LTV 衰减
在确保数据管线无缝衔接后,多维质量评分模型的数据输入层需要从海量明文日志中精准提纯三大核心评估维度:
- 初期触达质量(激活与注册转化率):这代表了渠道人群与 App 调性的初始匹配度。模型将提取点击到激活、激活到注册的漏斗折损率,快速过滤掉那些存在高频点击劫持或机器秒退的低质网段。
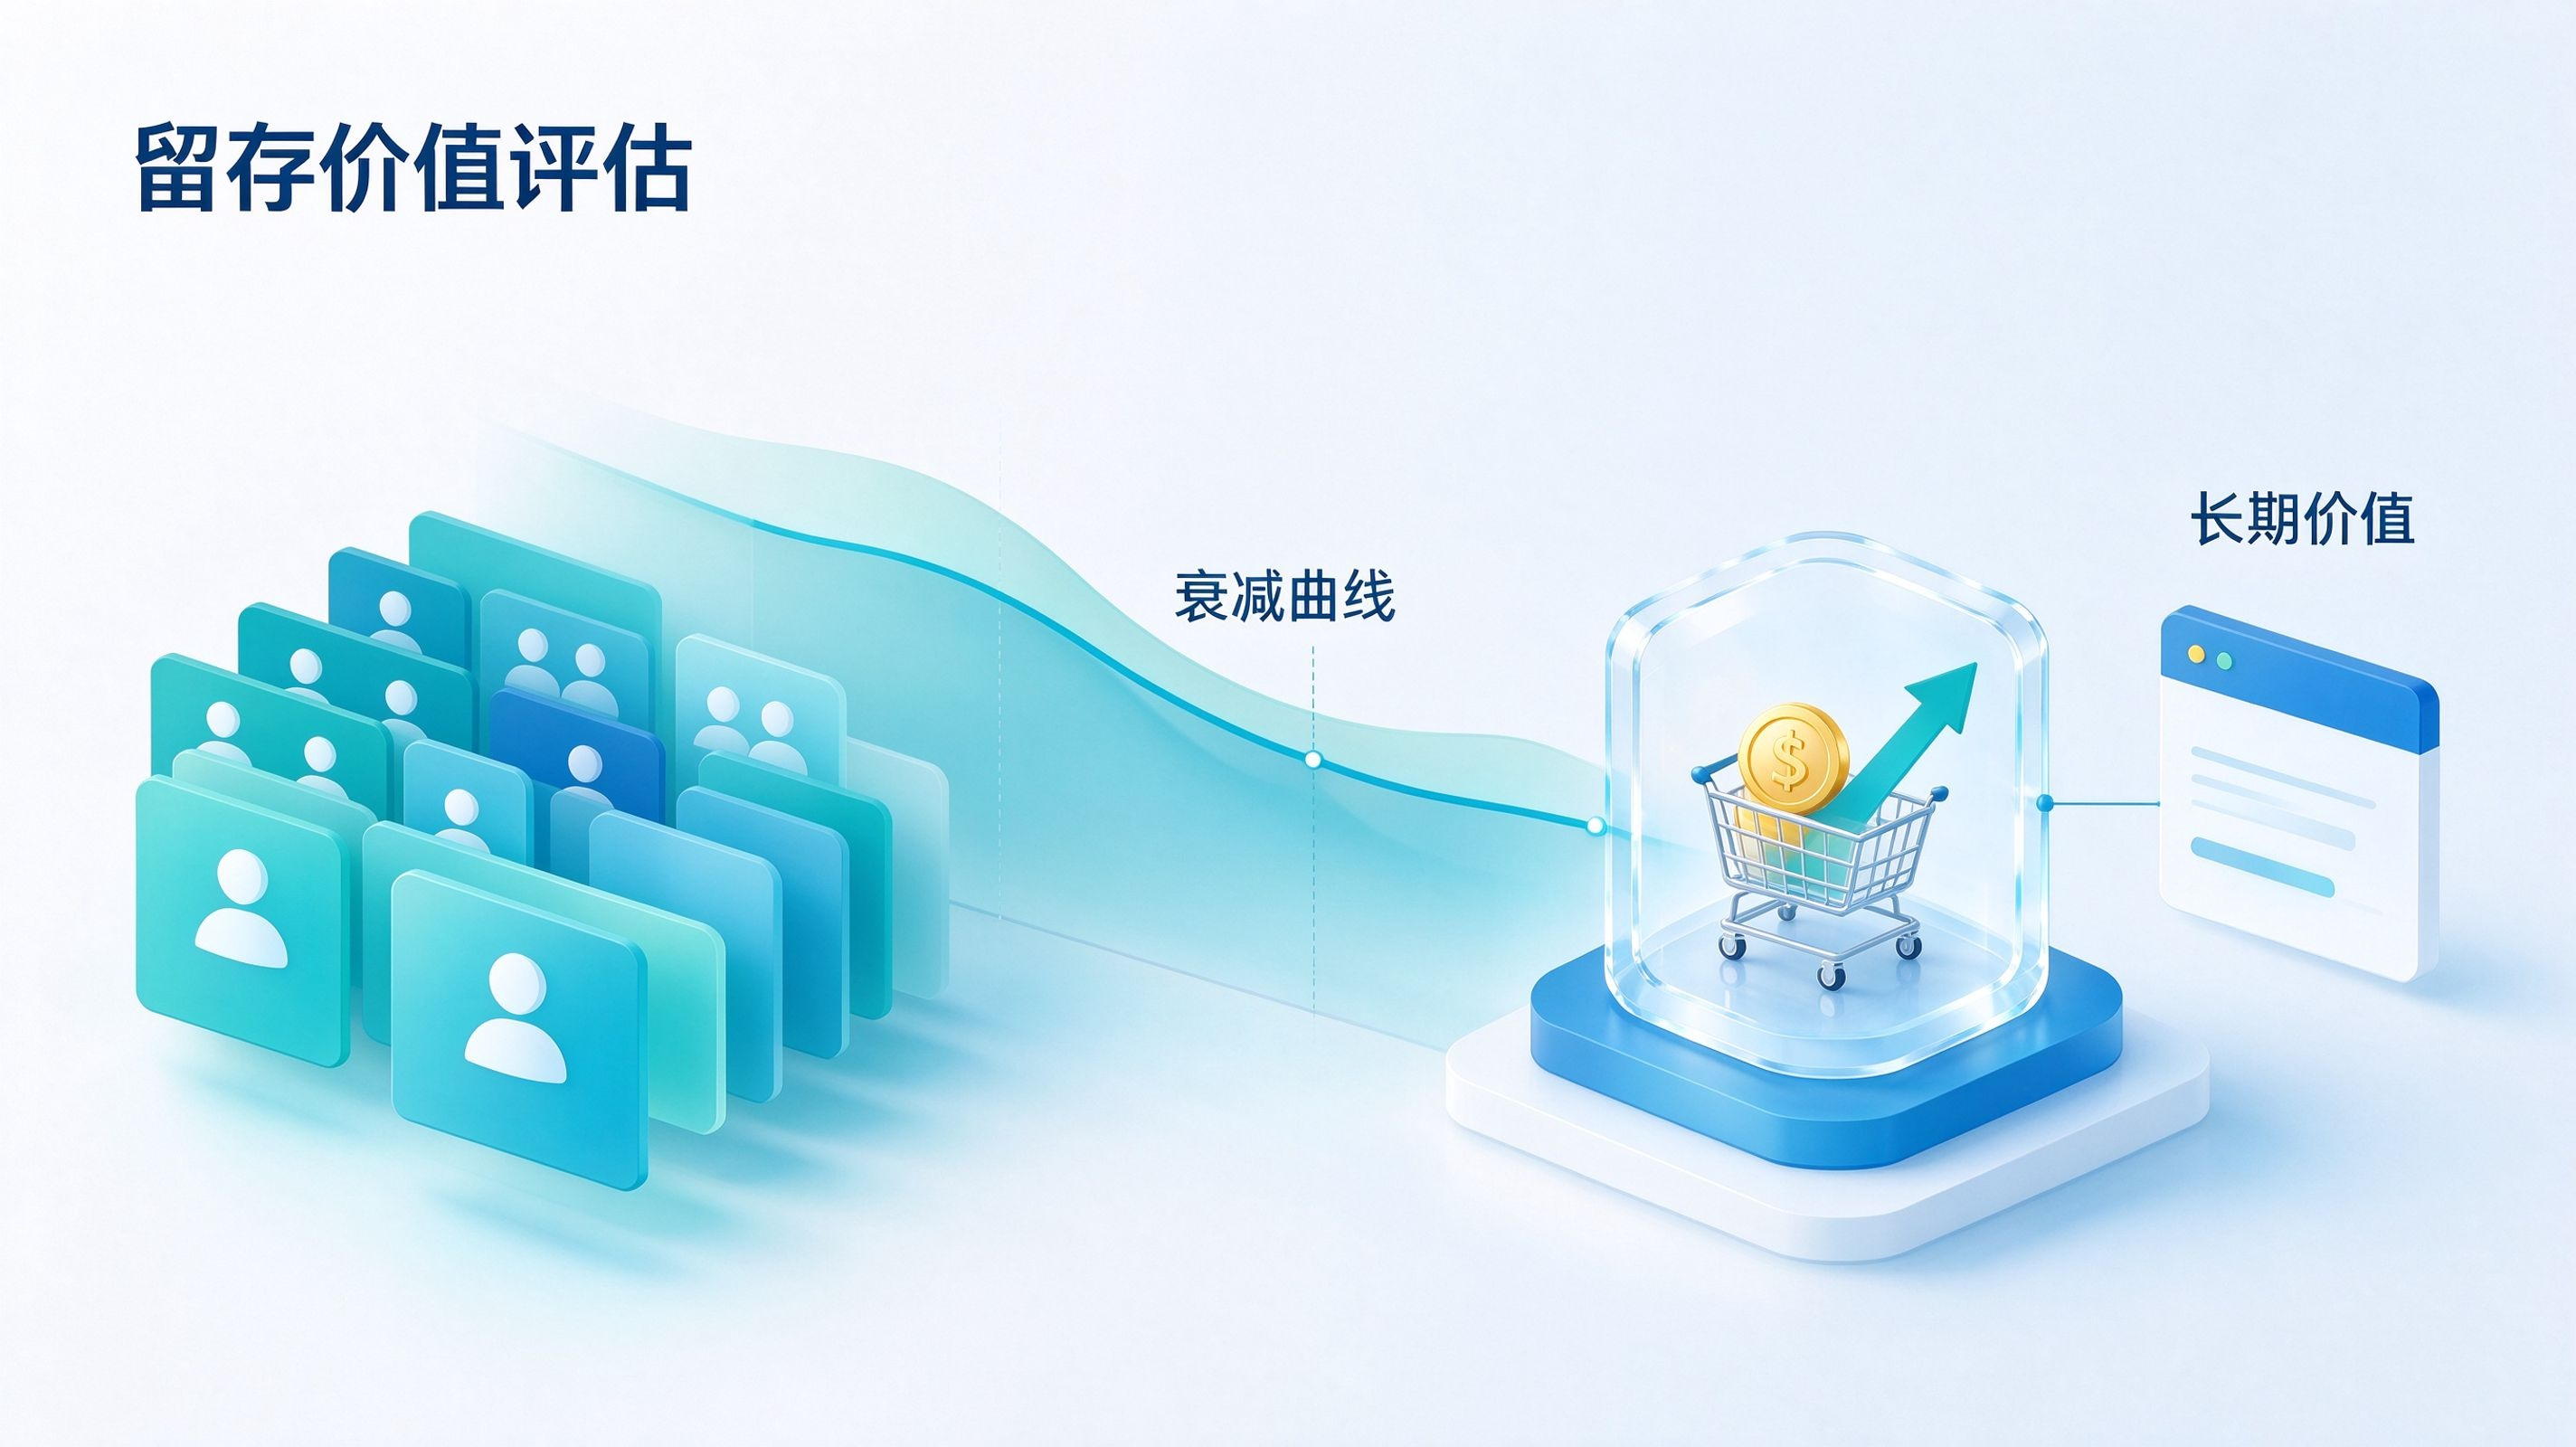
- 中期活跃黏性(群组留存曲线):这是甄别积分墙和羊毛党的试金石。模型不看单一的次留,而是追踪同一批次用户在长周期的留存对数衰减模型。真实渠道的衰减曲线应当平滑且趋于稳定,而作弊渠道则会在奖励发放日后呈现垂直的"留存断崖"。
- 长期商业变现(ARPU 与 LTV 预测):这是终极裁决指标。模型提取群组内的首充转化率、复购频次分布以及平均客单价(ARPU)。对于长决策周期的重度业务,模型还会结合历史沉淀的大盘算法,利用前 7 天的微转化事件提前推演并拟合出该渠道用户在 30 天或 90 天内的生命周期总价值。
多维质量评分公式(Q-Score)的动态权重分配
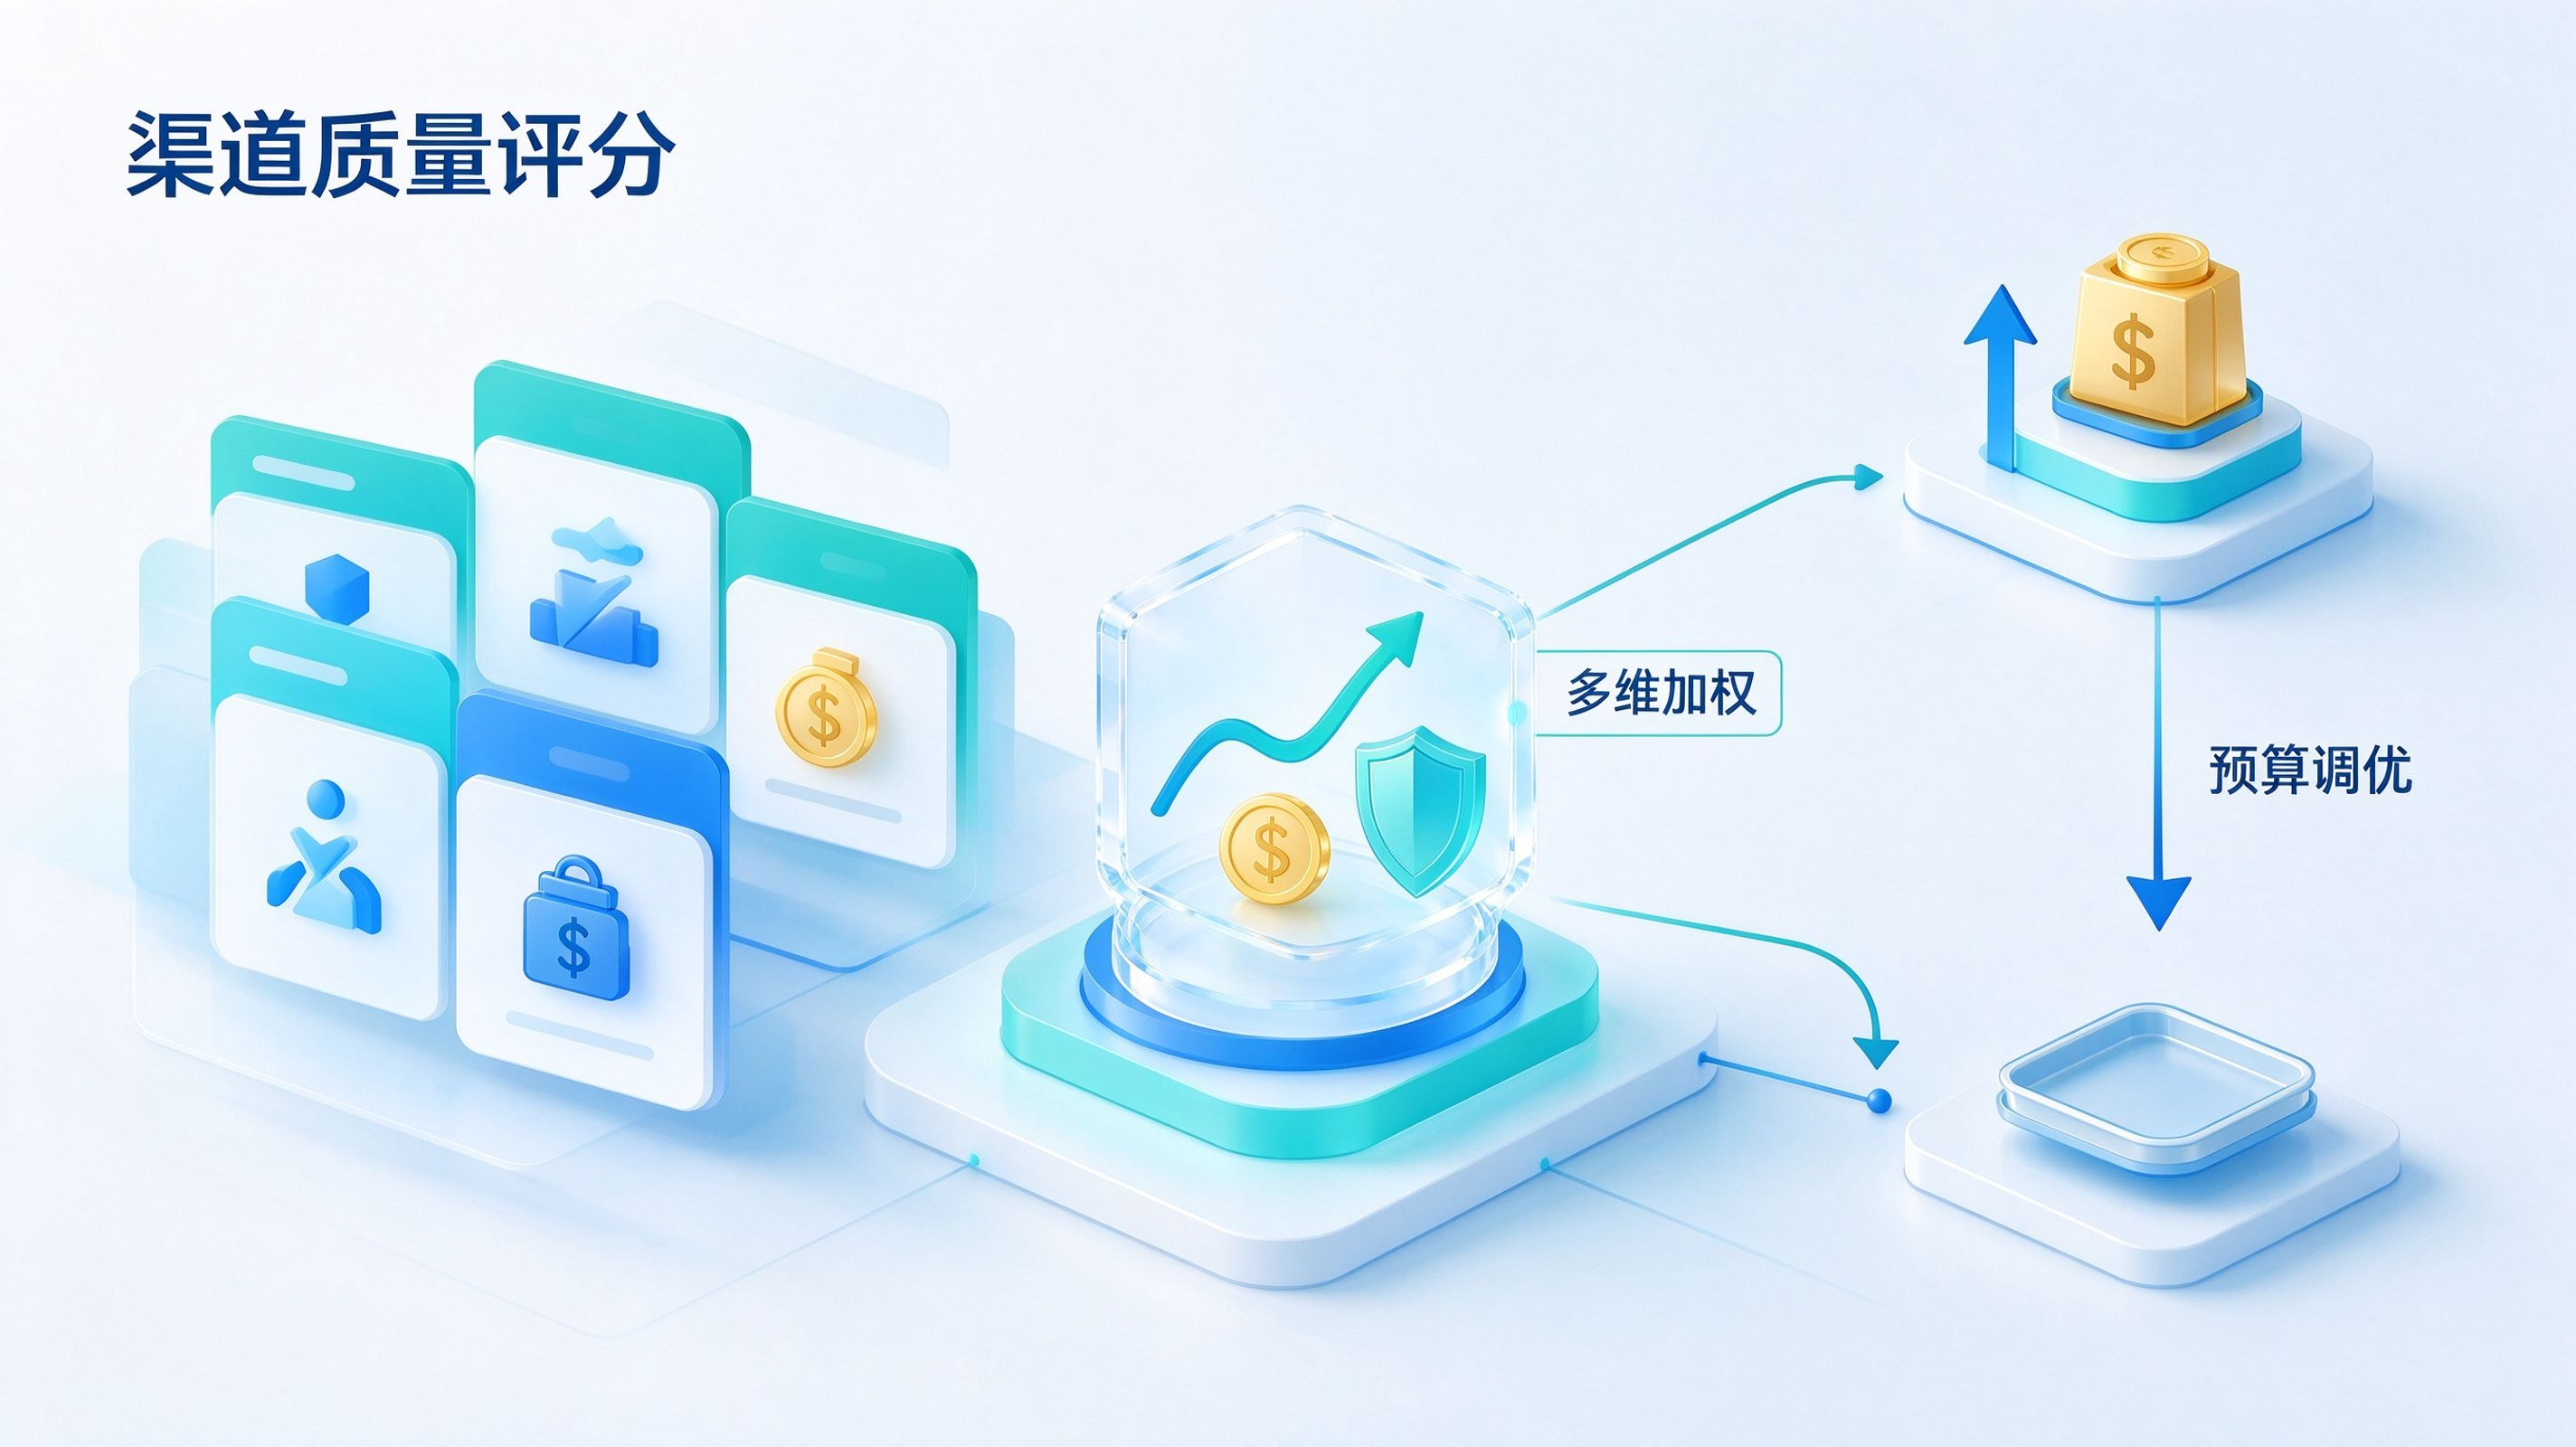
在集齐了三大核心维度的特征值后,数据科学家需要构建一个可量化、可自动输出评价的综合质量评分公式(Q-Score):
- 经典加权代数模型结构:( Q_Score = W1 \times Retention + W2 \times ARPU + W3 \times Deep_CVR - Penalty(Risk_Score) )。
- 动态权重自适应:权重 W 会根据产品所处的生命周期进行动态自适应:在 App 上线初期,留存权重极高;在商业化变现期,付费权重成为主导。
- 风控惩罚项:对被风控探针命中异常聚集的渠道,系统会自动赋予负向的惩罚项。通过这种多维权重的打分逻辑,企业能迅速在报表中识别出那些"高激活、低付费"的劣质流量,并依然确保系统整体综合归因率高达 98% 的技术水位。
核心实现代码与数据管线示例
1. 渠道综合质量评分 (Q-Score) 计算模型 (Python 示例)
from typing import Dict

def calculate_channel_value(data: Dict, weights: Dict) -> float:
    """
    data: dict, 包含 'retention', 'arpu', 'cvr', 'fraud_risk' (均为0-100归一化数值)
    weights: dict, 包含各维度的加权系数 (w_ret, w_pay, w_cvr)
    """
    # 提取维度数值
    ret = data.get('retention', 0)
    rev = data.get('arpu', 0)
    cvr = data.get('cvr', 0)
    risk = data.get('fraud_risk', 0)

    # 动态加权求和 - 风险扣分惩罚
    raw_score = (
        ret * weights.get('w_ret', 0.4) +
        rev * weights.get('w_pay', 0.4) +
        cvr * weights.get('w_cvr', 0.2)
    ) - risk

    # 确保输出范围在 0-100 之间
    return round(max(0, min(100, raw_score)), 2)

# 场景示例:产品步入成熟期,提高付费贡献权重
config = {'w_ret': 0.2, 'w_pay': 0.7, 'w_cvr': 0.1}
channel_a = {'retention': 85, 'arpu': 92, 'cvr': 70, 'fraud_risk': 2}

print(f"当前渠道最终得分: {calculate_channel_value(channel_a, config)}")
2. 留存衰减模型与 LTV 预测 (Python 伪代码示例)
import numpy as np
from typing import List, Dict

class RetentionDecayModel:
    def __init__(self, decay_lambda: float = 0.5):
        self.decay_lambda = decay_lambda

    def predict_retention_curve(self, initial_retention: float, days: int = 30) -> List[float]:
        """
        预测留存衰减曲线(基于指数衰减模型)
        """
        return [initial_retention * np.exp(-self.decay_lambda * d) for d in range(days)]

    def predict_ltv(self, initial_retention: float, arpu: float, days: int = 90) -> float:
        """
        预测 LTV(基于留存衰减曲线与 ARPU)
        """
        retention_curve = self.predict_retention_curve(initial_retention, days)
        return sum(retention_curve) * arpu

# 示例:留存衰减与 LTV 预测
model = RetentionDecayModel(decay_lambda=0.5)
initial_retention = 0.85  # 初始留存率
arpu = 12.5  # 平均每用户收入

retention_curve = model.predict_retention_curve(initial_retention, days=30)
ltv = model.predict_ltv(initial_retention, arpu, days=90)
print(f"30 日留存衰减曲线:{retention_curve}")
print(f"90 日 LTV 预测:{ltv}")
指标体系与技术评估框架
为了清晰衡量不同渠道评估体系在颗粒度深度、时效性与防骗量能力上的综合表现,架构组制定了如下对比矩阵:
| 评估体系架构模型 | 颗粒度深度与洞察力 | 时效性与决策周期 | 防骗量与风控能力 | 数据串联的人力成本 |
|---|---|---|---|---|
| 媒体后台浅层报表 | 极浅(仅看安装,无法透视后续行为) | 实时 | 极差 | 零成本 |
| 人工 Excel 拼接 T+1 | 中等(运营手工将媒体消耗表与付费表对账) | 极差 | 较弱 | 极高 |
| Open+ 归一化实时评分模型 | 极深(底层物理标识贯穿生命周期) | 极快(流计算动态更新,分钟级干预) | 极强(融合指纹校验,直击刷量死穴) | 极低 |
技术诊断案例模块:某社交 App 剥离“高激活低留存”劣质渠道
异常现象与排查背景
国内某头部社交 App 为了冲击年度日活 KPI,投入百万预算测试了多个信息流渠道。渠道 A 的前端表现亮眼,激活成本仅为均值的 1/3,每日带量破万。然而,公司后端的真实充值流水却毫无增长,服务器负载反而因大量“签到党”白嫖资源而频频预警。
日志与链路对账
数据架构师调取了基于 Open+ 归因底座串联的群组分析报表。经过对撞发现:渠道 A 的新增用户次日留存率仅为 8%,且七日留存直接归零;更可疑的是,90% 的请求上报地址收敛在特定 IDC 代理池中,完全违背了 C 端用户随机分布的物理特征。
技术介入与规则调优
团队在 Open+ 中台配置了“自适应权重打分”,将该渠道的“注册”权重下调至 10%,将“付费成功”权重拉升至 70%。同时在网关层通过特征指纹自动拦截高度聚集的机房 IP 来源。针对异常 API 调用,实施动态 CTIT 校验拦截。
复盘结果与经验
预算重组后,该 App 整体的投放 ROI 逆势飙升了 24.6%,回本周期缩短了 15 天。在清洗掉脏数据的同时,系统整体归因率稳固保持在高达 98% 的水位,确立了“抛弃虚假数据,拥抱深度打分”的增长信仰。
常见问题与参考资料
长决策周期的行业(如金融、汽车)如何快速评估渠道质量?
不能死等 30 天后的最终成交。必须在评分模型中引入“高意向微转化事件”(例如:完成实名认证 OCR、深度浏览车型配置页超过 3 分钟),并赋予这些微转化中等偏上的权重。结合历史数据,利用预测模型提前拟合其长效价值。
当内部 BI 数据与媒体后台的报表出现严重对账偏差时听谁的?
必须以中立的第三方归因中台基于严格 Last-Click 时序校验的数据为准。媒体报表通常包含水分极大的浏览归因,唯有成功匹配了物理硬指纹、且在业务库中生成了唯一订单主键的数据才是真实的效果资产。
多维评分模型的特征权重应该多久更新一次?
建议结合业务大促周期与版本大更新进行按月迭代。如果当前目标是抢占市场份额,则上调留存权重;若面临财务压力,则必须极端放大 ARPU 与 ROI 权重,实现策略的自适应。
参考资料
- Apple: App Store Connect - App Analytics。
- Google: Play Console - App statistics。
- Improvado: Marketing Anomaly Detection & Automated Alerts。
文章标签:全渠道归因、深度链接、归因技术、传参安装、广告监测、实时数据看板、归因配置、广告回传、广告反作弊、虚假点击识别