多触点归因模型怎么选?从 Last Click、First Click、线性、时间衰减到算法归因全链路解析
 openinstall运营团队|
 2026-09-24|
 129
当用户在转化前平均经历 5-8 个触点(如搜索广告、展示广告、社交媒体、邮件营销、KOL 推荐、应用商店搜索)、各触点贡献度差异巨大时,如何彻底摒弃传统"单一 Last Click 归因忽略中间触点、First Click 低估收尾渠道、线性归因平均主义"的粗放模式,利用 Open+ 广告监测能力 构建一套"Last Click、First Click、线性、时间衰减、位置归因(U 型/W 型)、算法归因(马尔科夫链、夏普里值)"的全链路多触点归因体系,将渠道贡献评估误差率大幅降低至 1.5% 以下? 核心答案是:通过 Last Click、First Click、线性、时间衰减、位置归因(U 型/W 型)与算法归因(马尔科夫链、夏普里值)六大模型的动态选择与权重配置,根据业务特性(如电商、游戏、金融、教育)与用户决策链路(如短链路决策、长链路决策)科学评估各渠道贡献;配合时间衰减归因的半衰期配置、位置归因的首尾权重配置与算法归因的边际贡献计算,最终在企业服务端形成涵盖曝光、点击、安装、激活、注册、付费及留存的全链路实时数据看板。传统方案单一 Last Click 归因忽略中间触点,渠道贡献评估误差率超过 50%;而现代多触点归因架构通过六大模型的动态选择与权重配置,最终将渠道贡献评估误差率控制在 1.5% 以内。
物理断层与行业痛点
Last Click 归因的局限性:为什么 60% 的中间触点贡献被忽略
在多渠道协同投放与用户长链路决策的时代,传统单一 Last Click 归因方案往往陷入"中间触点贡献被完全忽略 + 投放策略严重偏向收尾渠道"的粗放模式,其技术瓶颈与数据盲区已完全脱离现代精细化增长逻辑:
- 两步死亡陷阱的转化折损:Last Click 将 100% 功劳归于最后一次点击 → 中间触点(如品牌曝光、内容种草、KOL 推荐)的贡献被完全忽略 → 投放策略严重偏向收尾渠道(如搜索广告、重定向广告),导致品牌建设与内容营销预算被大幅压缩。
- First Click 归因的困境:First Click 将 100% 功劳归于第一次点击 → 收尾渠道(如搜索广告、重定向广告)的贡献被完全低估 → 投放策略严重偏向拉新渠道(如展示广告、社交媒体广告),导致转化优化预算被大幅压缩。
- 确立多触点归因新范式:根据业务特性(如电商、游戏、金融、教育)与用户决策链路(如短链路决策、长链路决策)动态选择归因模型,配合 多渠道归因分析怎么做?用 openinstall 聚合广告与自然流量数据 实现精准渠道贡献评估。
线性归因与时间衰减归因的权重配置困惑:为什么渠道贡献评估误差率超过 50%
线性归因的平均主义危机与时间衰减归因的权重配置困惑,使渠道贡献评估面临严峻挑战:
- 线性归因的平均主义危机:线性归因将功劳平均分配给所有触点 → 低意图早期曝光(如品牌展示广告)与高意图收尾点击(如搜索广告)获得相同功劳 → 渠道贡献评估严重失真。
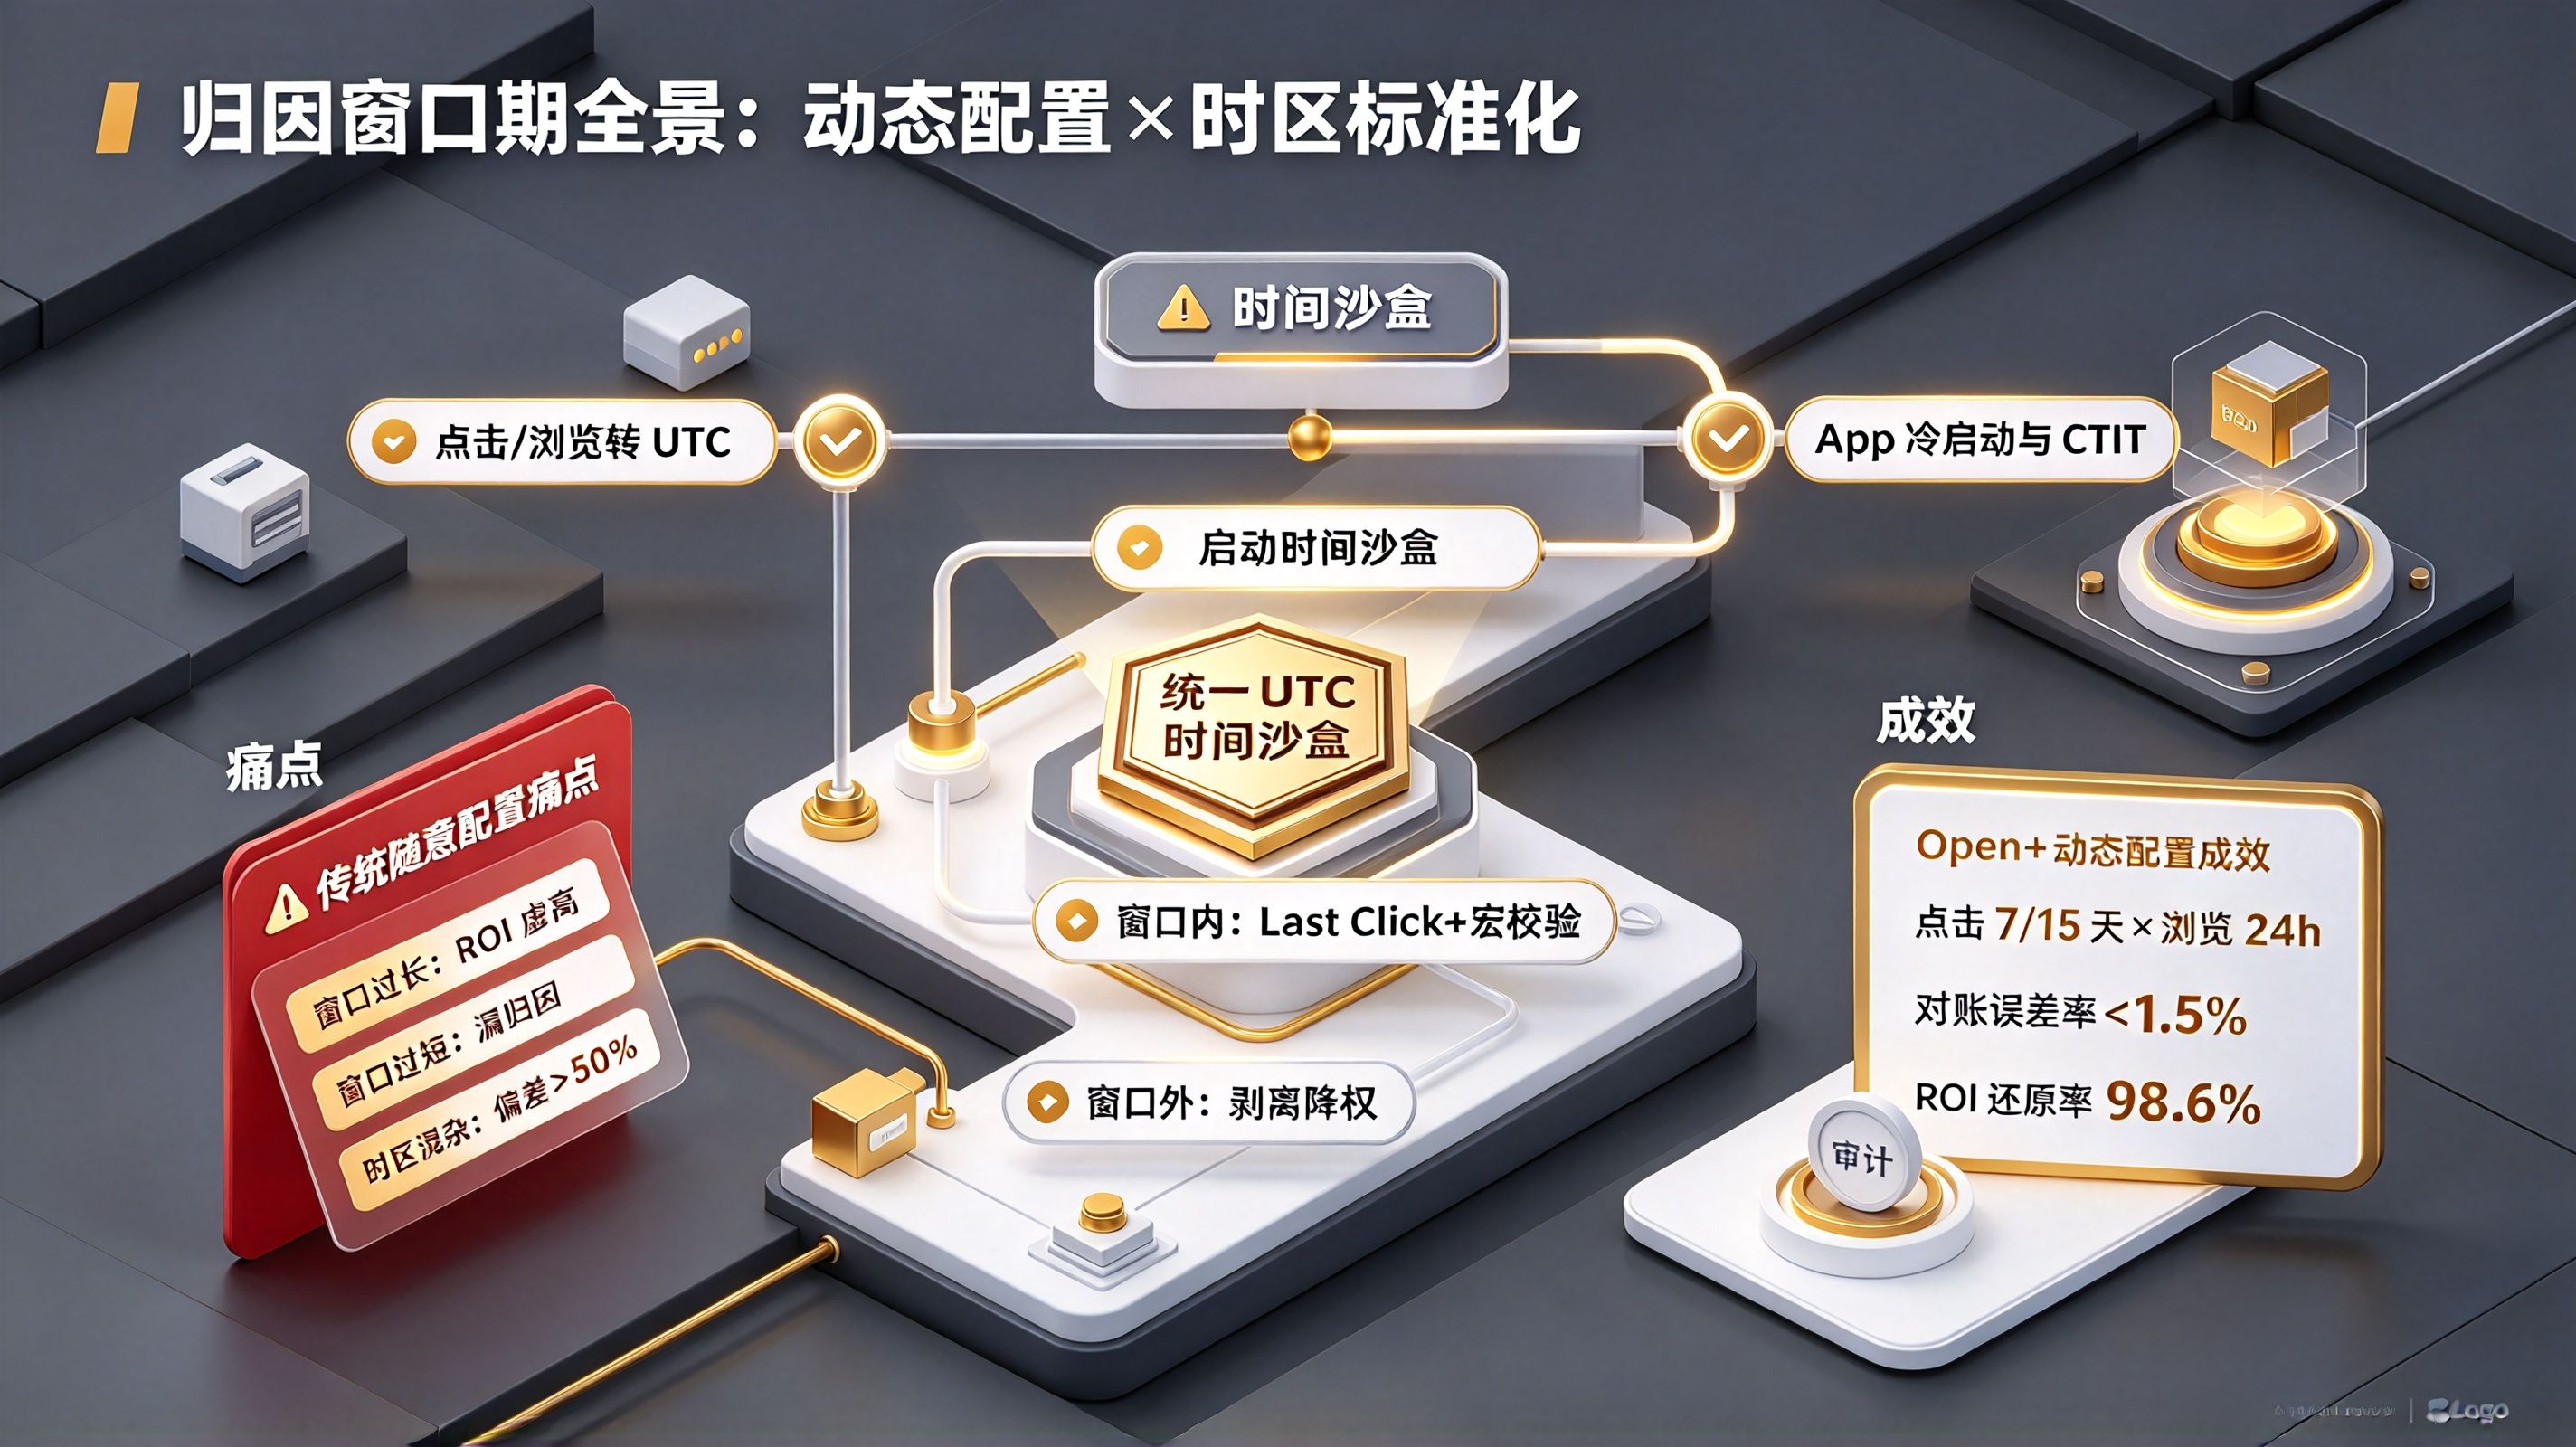
- 时间衰减归因的权重配置困惑:时间衰减归因给予临近转化的触点更高权重,但权重衰减速率(如半衰期 7 天、3 天、1 天)难以科学配置 → 渠道贡献评估误差率超过 50%。
- 确立多触点归因新范式:利用 Open+ 多触点归因模型与算法归因,内置主流行业归因模型模板(如电商 Last Click、金融时间衰减、教育 U 型),自动处理权重配置与渠道贡献评估,将误差率控制在 1.5% 以内。
底层原理与数据管线拆解
多触点归因的端云协同架构:如何实现 Last Click、First Click、线性、时间衰减、位置归因与算法归因
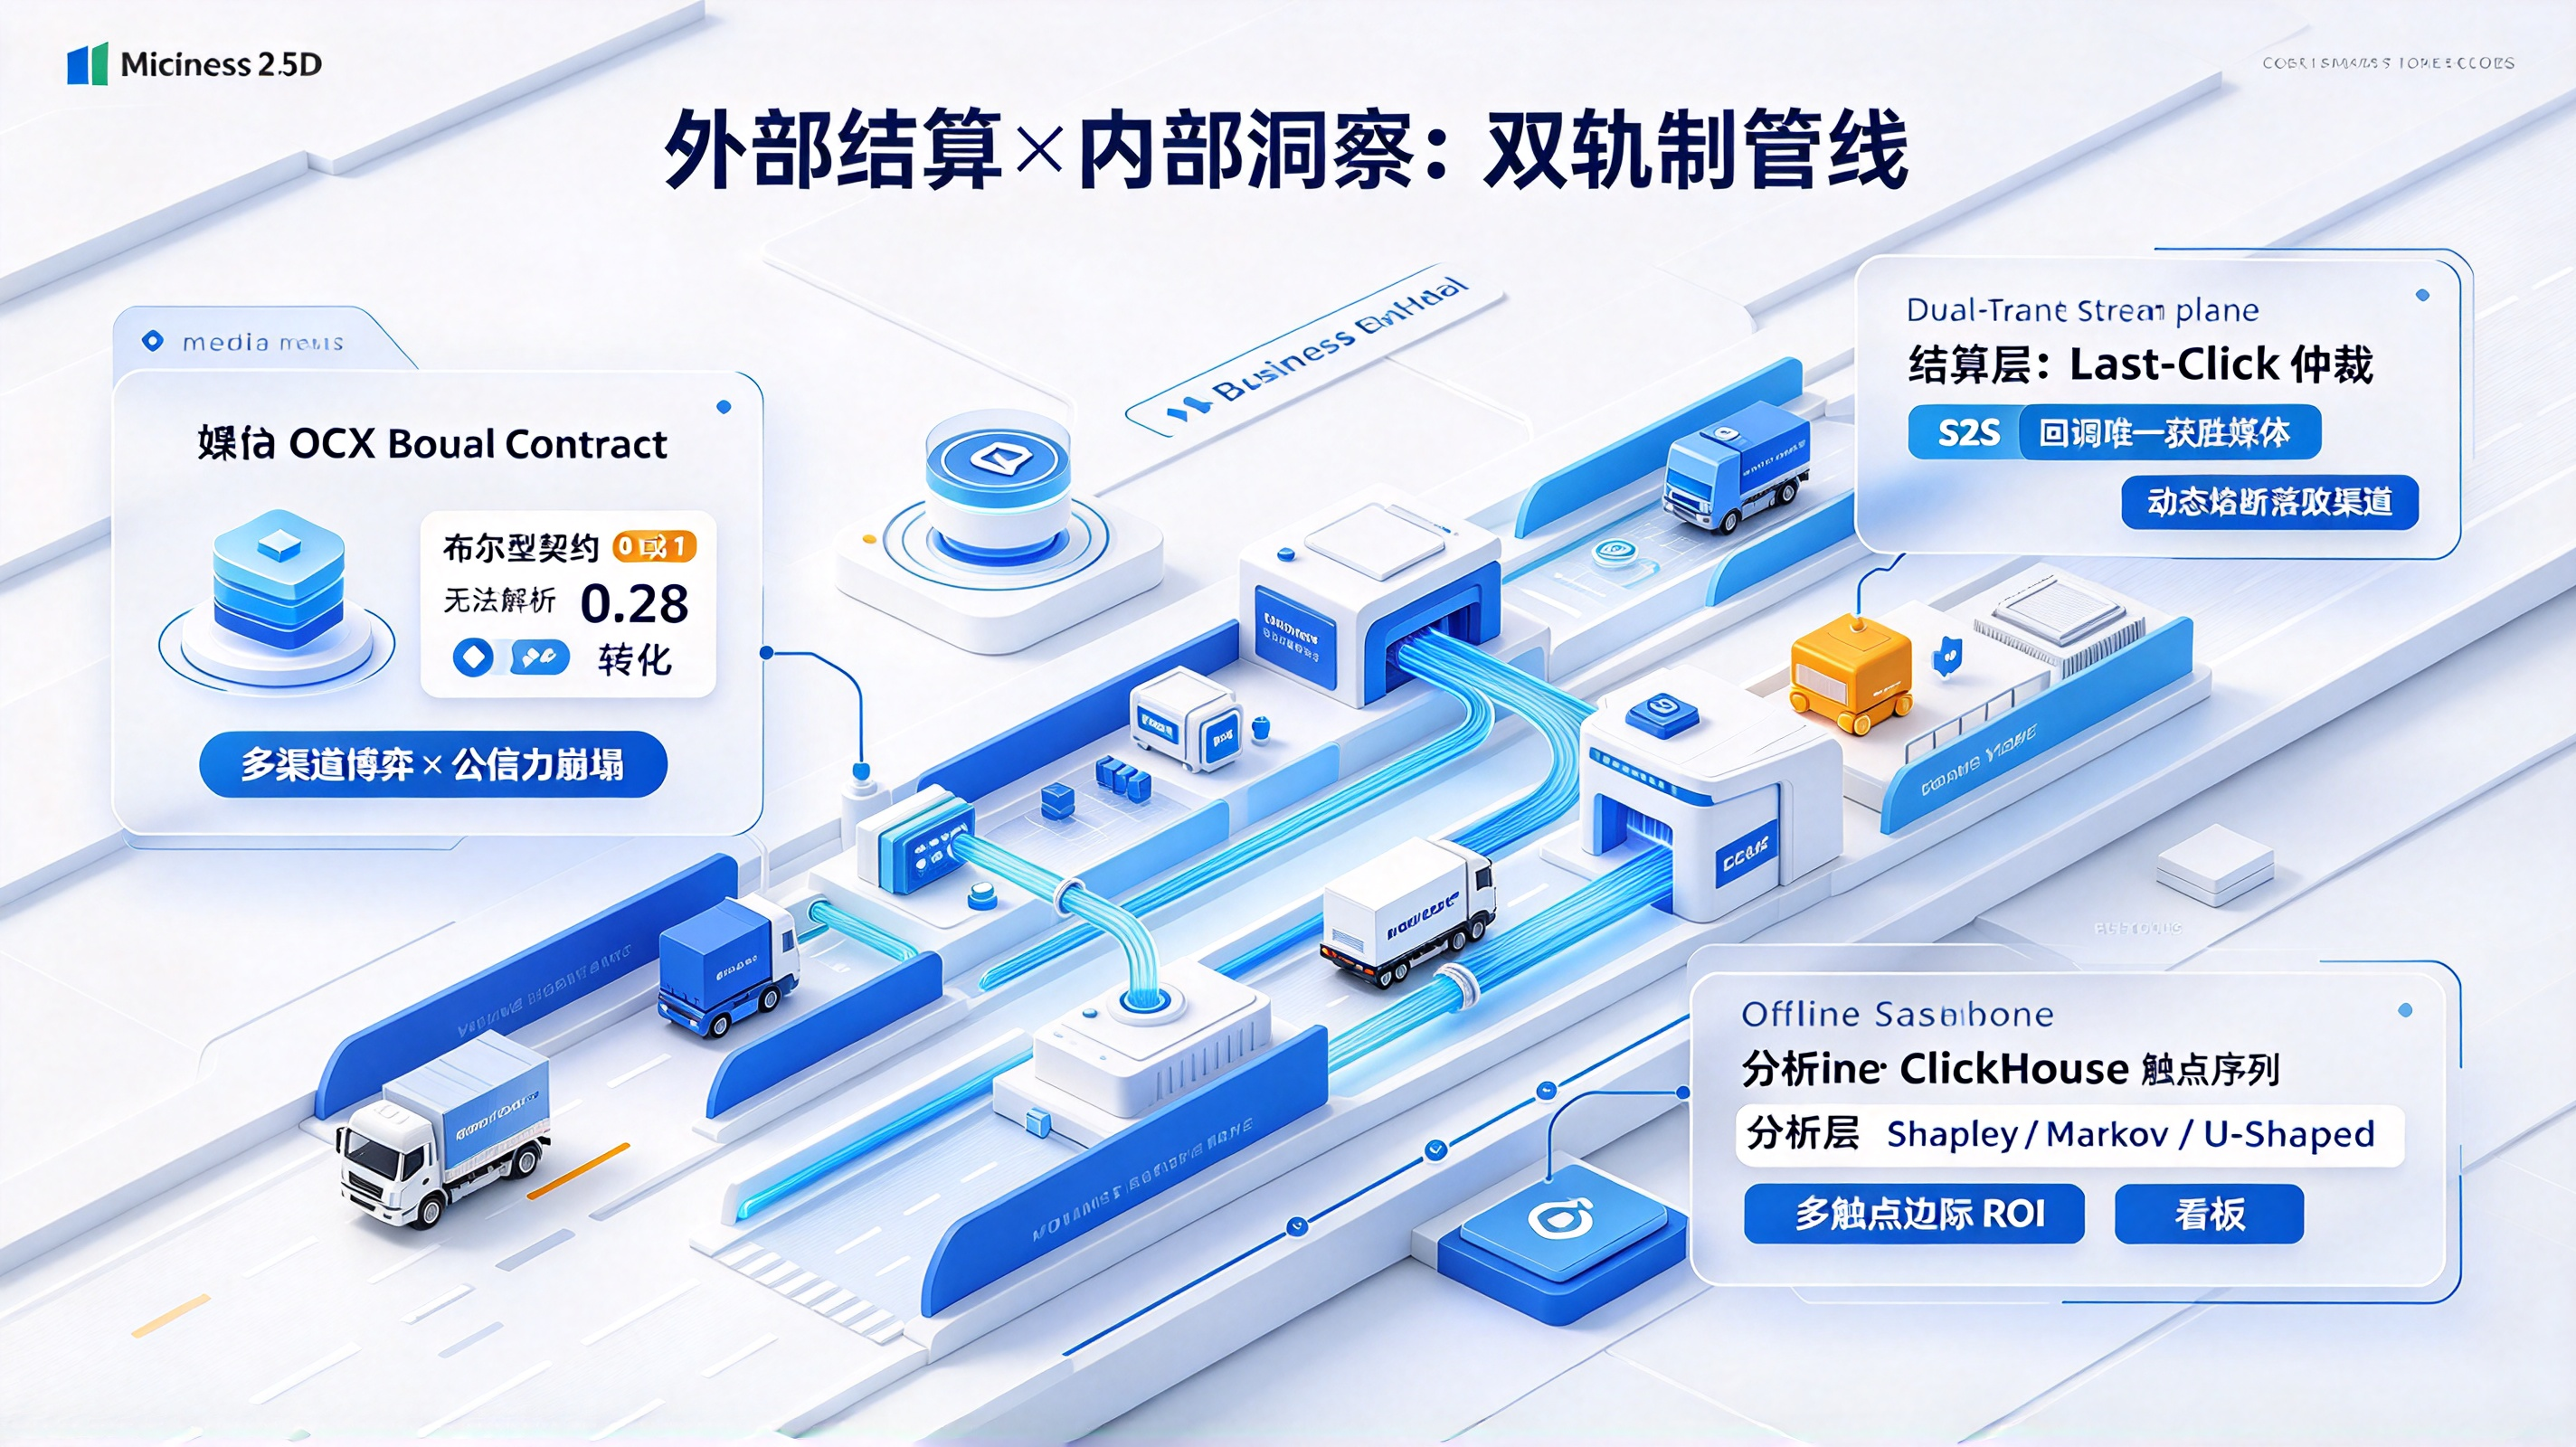
多触点归因的本质是跨越广告曝光、点击与 App 转化的"功劳分配"技术,其核心在于"Last Click、First Click、线性、时间衰减、位置归因(U 型/W 型)、算法归因(马尔科夫链、夏普里值)":
- Last Click 归因:将 100% 功劳归于最后一次点击,适用于短链路决策、转化导向型业务(如电商、游戏)。
- First Click 归因:将 100% 功劳归于第一次点击,适用于拉新导向型业务(如内容平台、社交媒体 App)。
- 线性归因:将功劳平均分配给所有触点,适用于各触点贡献相近的品牌/内容驱动型业务。
- 时间衰减归因:给予临近转化的触点更高权重,适用于长链路决策、早期触点种草、临近转化触点对决策影响更大的业务(如金融、教育)。
- 位置归因(U 型/W 型):U 型给予首尾触点各 40% 功劳、中间触点平分 20%;W 型给予首尾触点与转化前关键触点各 30% 功劳、其余触点平分 10%,适用于复杂决策链路业务。
- 算法归因(马尔科夫链、夏普里值):通过模拟删除某个触点带来的整体转化损失来计算该触点的边际贡献,适用于数据量大、触点复杂的大型企业。
[ 用户触点 1:展示广告 ] ──> [ 用户触点 2:社交媒体 ] ──> [ 用户触点 3:KOL 推荐 ]
                                              │
                                              ▼
                                 [ 用户触点 4:邮件营销 ] ──> [ 用户触点 5:搜索广告 ]
                                              │
                                              ▼
                                 [ 用户转化(如付费) ]
                                              │
                                              ▼
                                 [ 归因中台计算各触点功劳 ]
                                              │
                     ┌────────────────────────┼────────────────────────┐
                     ▼                        ▼                        ▼
            [ Last Click:搜索广告 100% ]  [ First Click:展示广告 100% ]  [ 线性:各触点 20% ]
                     │                        │                        │
                     ▼                        ▼                        ▼
            [ 时间衰减:搜索广告 50%、邮件 25%、KOL 15%、社交 7%、展示 3% ]
                     │
                     ▼
            [ U 型:展示广告 40%、搜索广告 40%、中间触点 20% ]
                     │
                     ▼
            [ 算法归因(马尔科夫链/夏普里值):边际贡献计算 ]
归因模型选择与权重配置
为了科学评估各渠道贡献,必须建立归因模型选择与权重配置:
- 归因模型选择:根据业务特性(如电商、游戏、金融、教育)与用户决策链路(如短链路决策、长链路决策)动态选择归因模型。
- 权重配置:时间衰减归因需配置权重衰减速率(如半衰期 7 天、3 天、1 天);位置归因需配置首尾触点权重(如 U 型 40%-20%-40%、W 型 30%-10%-30%-10%-20%)。
算法归因与边际贡献计算
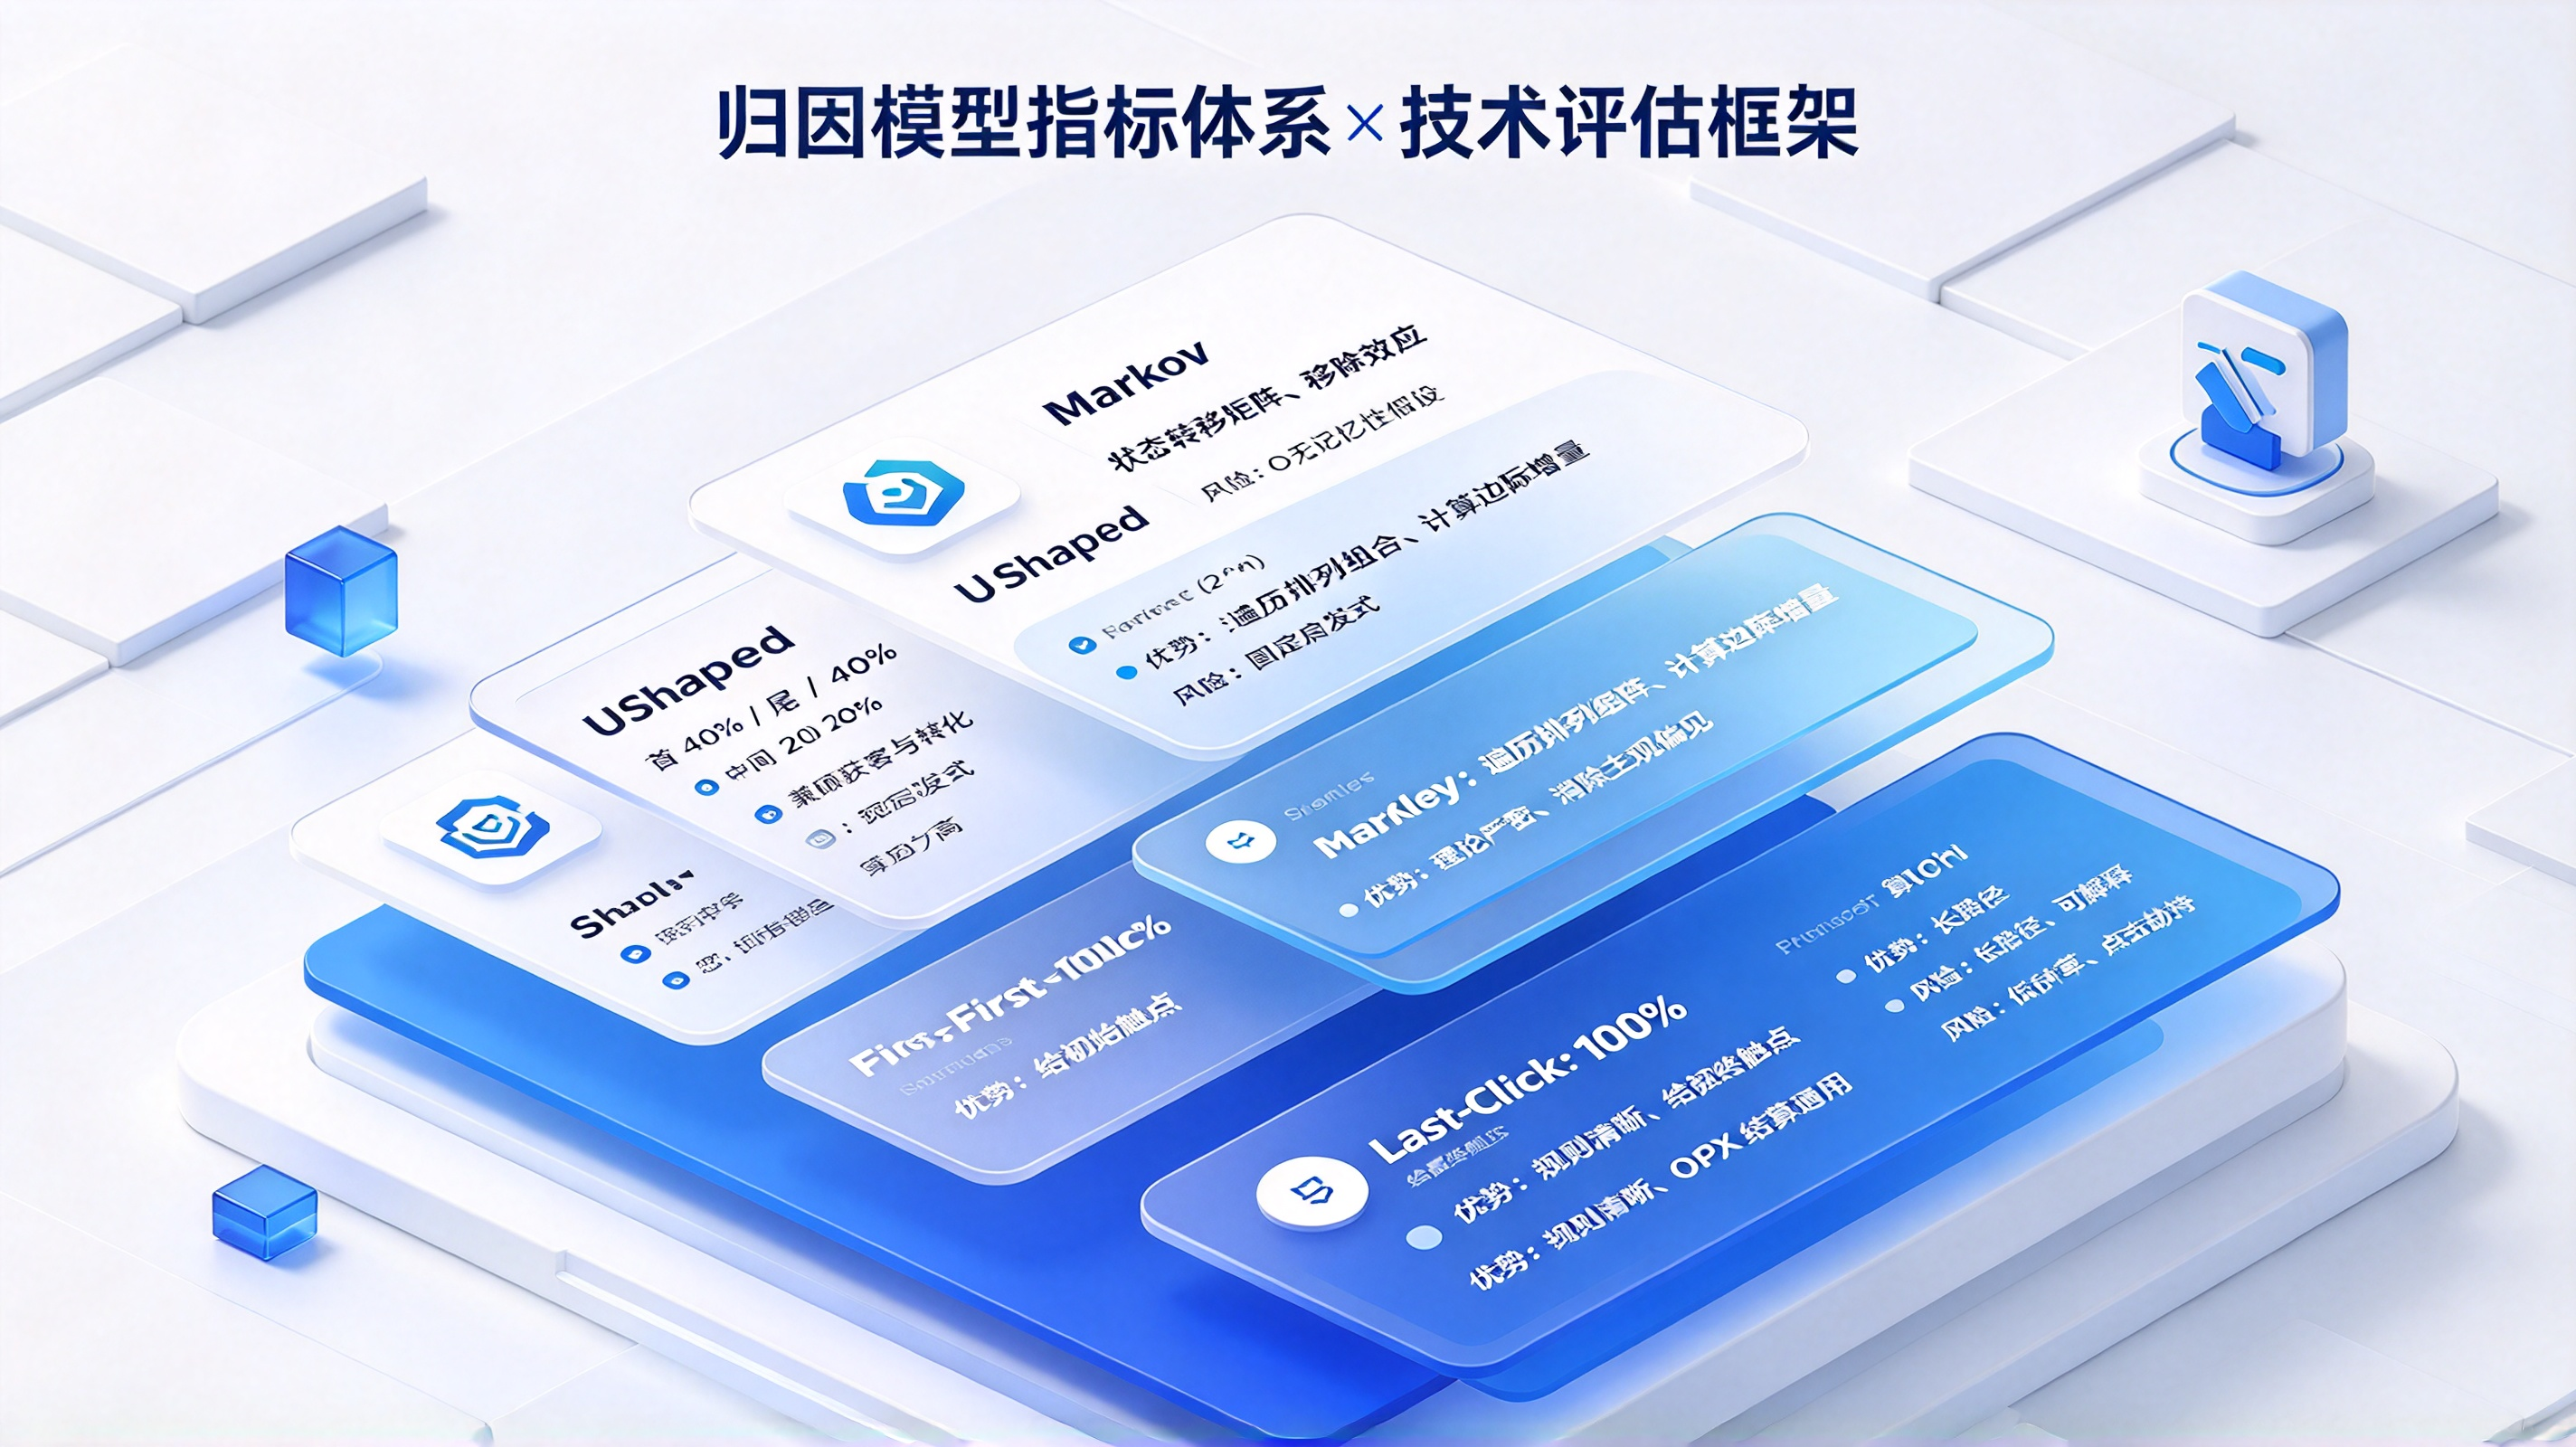
为了精准计算每个触点的边际贡献,必须配置算法归因:
- 马尔科夫链归因:通过构建用户触点转移概率矩阵,模拟删除某个触点后的整体转化损失,计算该触点的边际贡献。
- 夏普里值归因:基于博弈论中的夏普里值概念,计算每个触点在所有可能触点组合中的平均边际贡献。
核心实现代码与数据管线示例
多触点归因模型实现 (Python 伪代码示例)
from typing import Dict, List

class MultiTouchAttribution:
    def __init__(self):
        pass

    def last_click(self, touchpoints: List[Dict], conversion_value: float) -> Dict:
        """
        Last Click 归因:100% 功劳归于最后一次点击
        """
        attribution = {tp["channel"]: 0.0 for tp in touchpoints}
        attribution[touchpoints[-1]["channel"]] = conversion_value
        return attribution

    def first_click(self, touchpoints: List[Dict], conversion_value: float) -> Dict:
        """
        First Click 归因:100% 功劳归于第一次点击
        """
        attribution = {tp["channel"]: 0.0 for tp in touchpoints}
        attribution[touchpoints["channel"]] = conversion_value
        return attribution

    def linear(self, touchpoints: List[Dict], conversion_value: float) -> Dict:
        """
        线性归因:功劳平均分配给所有触点
        """
        credit_per_touchpoint = conversion_value / len(touchpoints)
        attribution = {tp["channel"]: credit_per_touchpoint for tp in touchpoints}
        return attribution

    def time_decay(self, touchpoints: List[Dict], conversion_value: float, half_life_days: int = 7) -> Dict:
        """
        时间衰减归因:给予临近转化的触点更高权重(指数衰减)
        """
        import math

        # 计算每个触点的权重(基于与转化的时间差)
        weights = []
        for i, tp in enumerate(touchpoints):
            days_before_conversion = len(touchpoints) - i - 1
            weight = math.exp(-math.log(2) * days_before_conversion / half_life_days)
            weights.append(weight)

        # 归一化权重
        total_weight = sum(weights)
        normalized_weights = [w / total_weight for w in weights]

        # 计算每个触点的功劳
        attribution = {}
        for tp, weight in zip(touchpoints, normalized_weights):
            channel = tp["channel"]
            attribution[channel] = attribution.get(channel, 0.0) + conversion_value * weight

        return attribution

    def position_based_u_shape(self, touchpoints: List[Dict], conversion_value: float) -> Dict:
        """
        位置归因(U 型):首尾触点各 40%,中间触点平分 20%
        """
        attribution = {tp["channel"]: 0.0 for tp in touchpoints}

        if len(touchpoints) == 1:
            attribution[touchpoints["channel"]] = conversion_value
        else:
            # 首尾触点各 40%
            attribution[touchpoints["channel"]] += conversion_value * 0.4
            attribution[touchpoints[-1]["channel"]] += conversion_value * 0.4

            # 中间触点平分 20%
            middle_credit = conversion_value * 0.2 / (len(touchpoints) - 2) if len(touchpoints) > 2 else 0.0
            for tp in touchpoints[1:-1]:
                attribution[tp["channel"]] += middle_credit

        return attribution

# 示例:多触点归因
attribution = MultiTouchAttribution()
touchpoints = [
    {"channel": "display_ad", "timestamp": "2026-09-17 10:00:00"},
    {"channel": "social_media", "timestamp": "2026-09-18 14:00:00"},
    {"channel": "email", "timestamp": "2026-09-19 09:00:00"},
    {"channel": "search_ad", "timestamp": "2026-09-20 16:00:00"},
]
conversion_value = 1000.0

print("Last Click:", attribution.last_click(touchpoints, conversion_value))
print("First Click:", attribution.first_click(touchpoints, conversion_value))
print("Linear:", attribution.linear(touchpoints, conversion_value))
print("Time Decay:", attribution.time_decay(touchpoints, conversion_value, half_life_days=7))
print("U-Shape:", attribution.position_based_u_shape(touchpoints, conversion_value))
算法归因(马尔科夫链)实现 (Python 伪代码示例)
from typing import Dict, List
import numpy as np

class MarkovChainAttribution:
    def __init__(self):
        pass

    def calculate_transition_matrix(self, user_journeys: List[List[str]]) -> np.ndarray:
        """
        计算用户触点转移概率矩阵
        """
        # 提取所有唯一触点(包括起始点、转化点、空点)
        all_states = set()
        for journey in user_journeys:
            all_states.update(journey)
        all_states = sorted(list(all_states))
        state_to_idx = {state: i for i, state in enumerate(all_states)}

        # 构建转移计数矩阵
        n_states = len(all_states)
        transition_counts = np.zeros((n_states, n_states))

        for journey in user_journeys:
            for i in range(len(journey) - 1):
                from_state = state_to_idx[journey[i]]
                to_state = state_to_idx[journey[i + 1]]
                transition_counts[from_state, to_state] += 1

        # 归一化为转移概率矩阵
        transition_matrix = transition_counts / transition_counts.sum(axis=1, keepdims=True)

        return transition_matrix, state_to_idx

    def calculate_removal_effect(self, transition_matrix: np.ndarray, state_to_idx: Dict, state_to_remove: str) -> float:
        """
        计算删除某个触点后的转化损失(移除效应)
        """
        # 简化示例:实际实现需构建马尔科夫链并计算转化概率
        # 此处仅返回伪代码逻辑
        return 0.1  # 伪返回值

    def calculate_shapley_value(self, user_journeys: List[List[str]], conversion_value: float) -> Dict:
        """
        计算夏普里值(每个触点的平均边际贡献)
        """
        # 提取所有唯一触点
        all_channels = set()
        for journey in user_journeys:
            all_channels.update(journey)
        all_channels = sorted(list(all_channels))

        # 计算每个触点的夏普里值
        shapley_values = {channel: 0.0 for channel in all_channels}

        # 简化示例:实际实现需遍历所有可能的触点组合
        for channel in all_channels:
            shapley_values[channel] = conversion_value / len(all_channels)  # 伪返回值

        return shapley_values

# 示例:算法归因
markov = MarkovChainAttribution()
user_journeys = [
    ["display_ad", "social_media", "search_ad", "conversion"],
    ["social_media", "email", "search_ad", "conversion"],
    ["display_ad", "email", "conversion"],
]
conversion_value = 1000.0

shapley_values = markov.calculate_shapley_value(user_journeys, conversion_value)
print("Shapley Values:", shapley_values)
指标体系与技术评估框架'
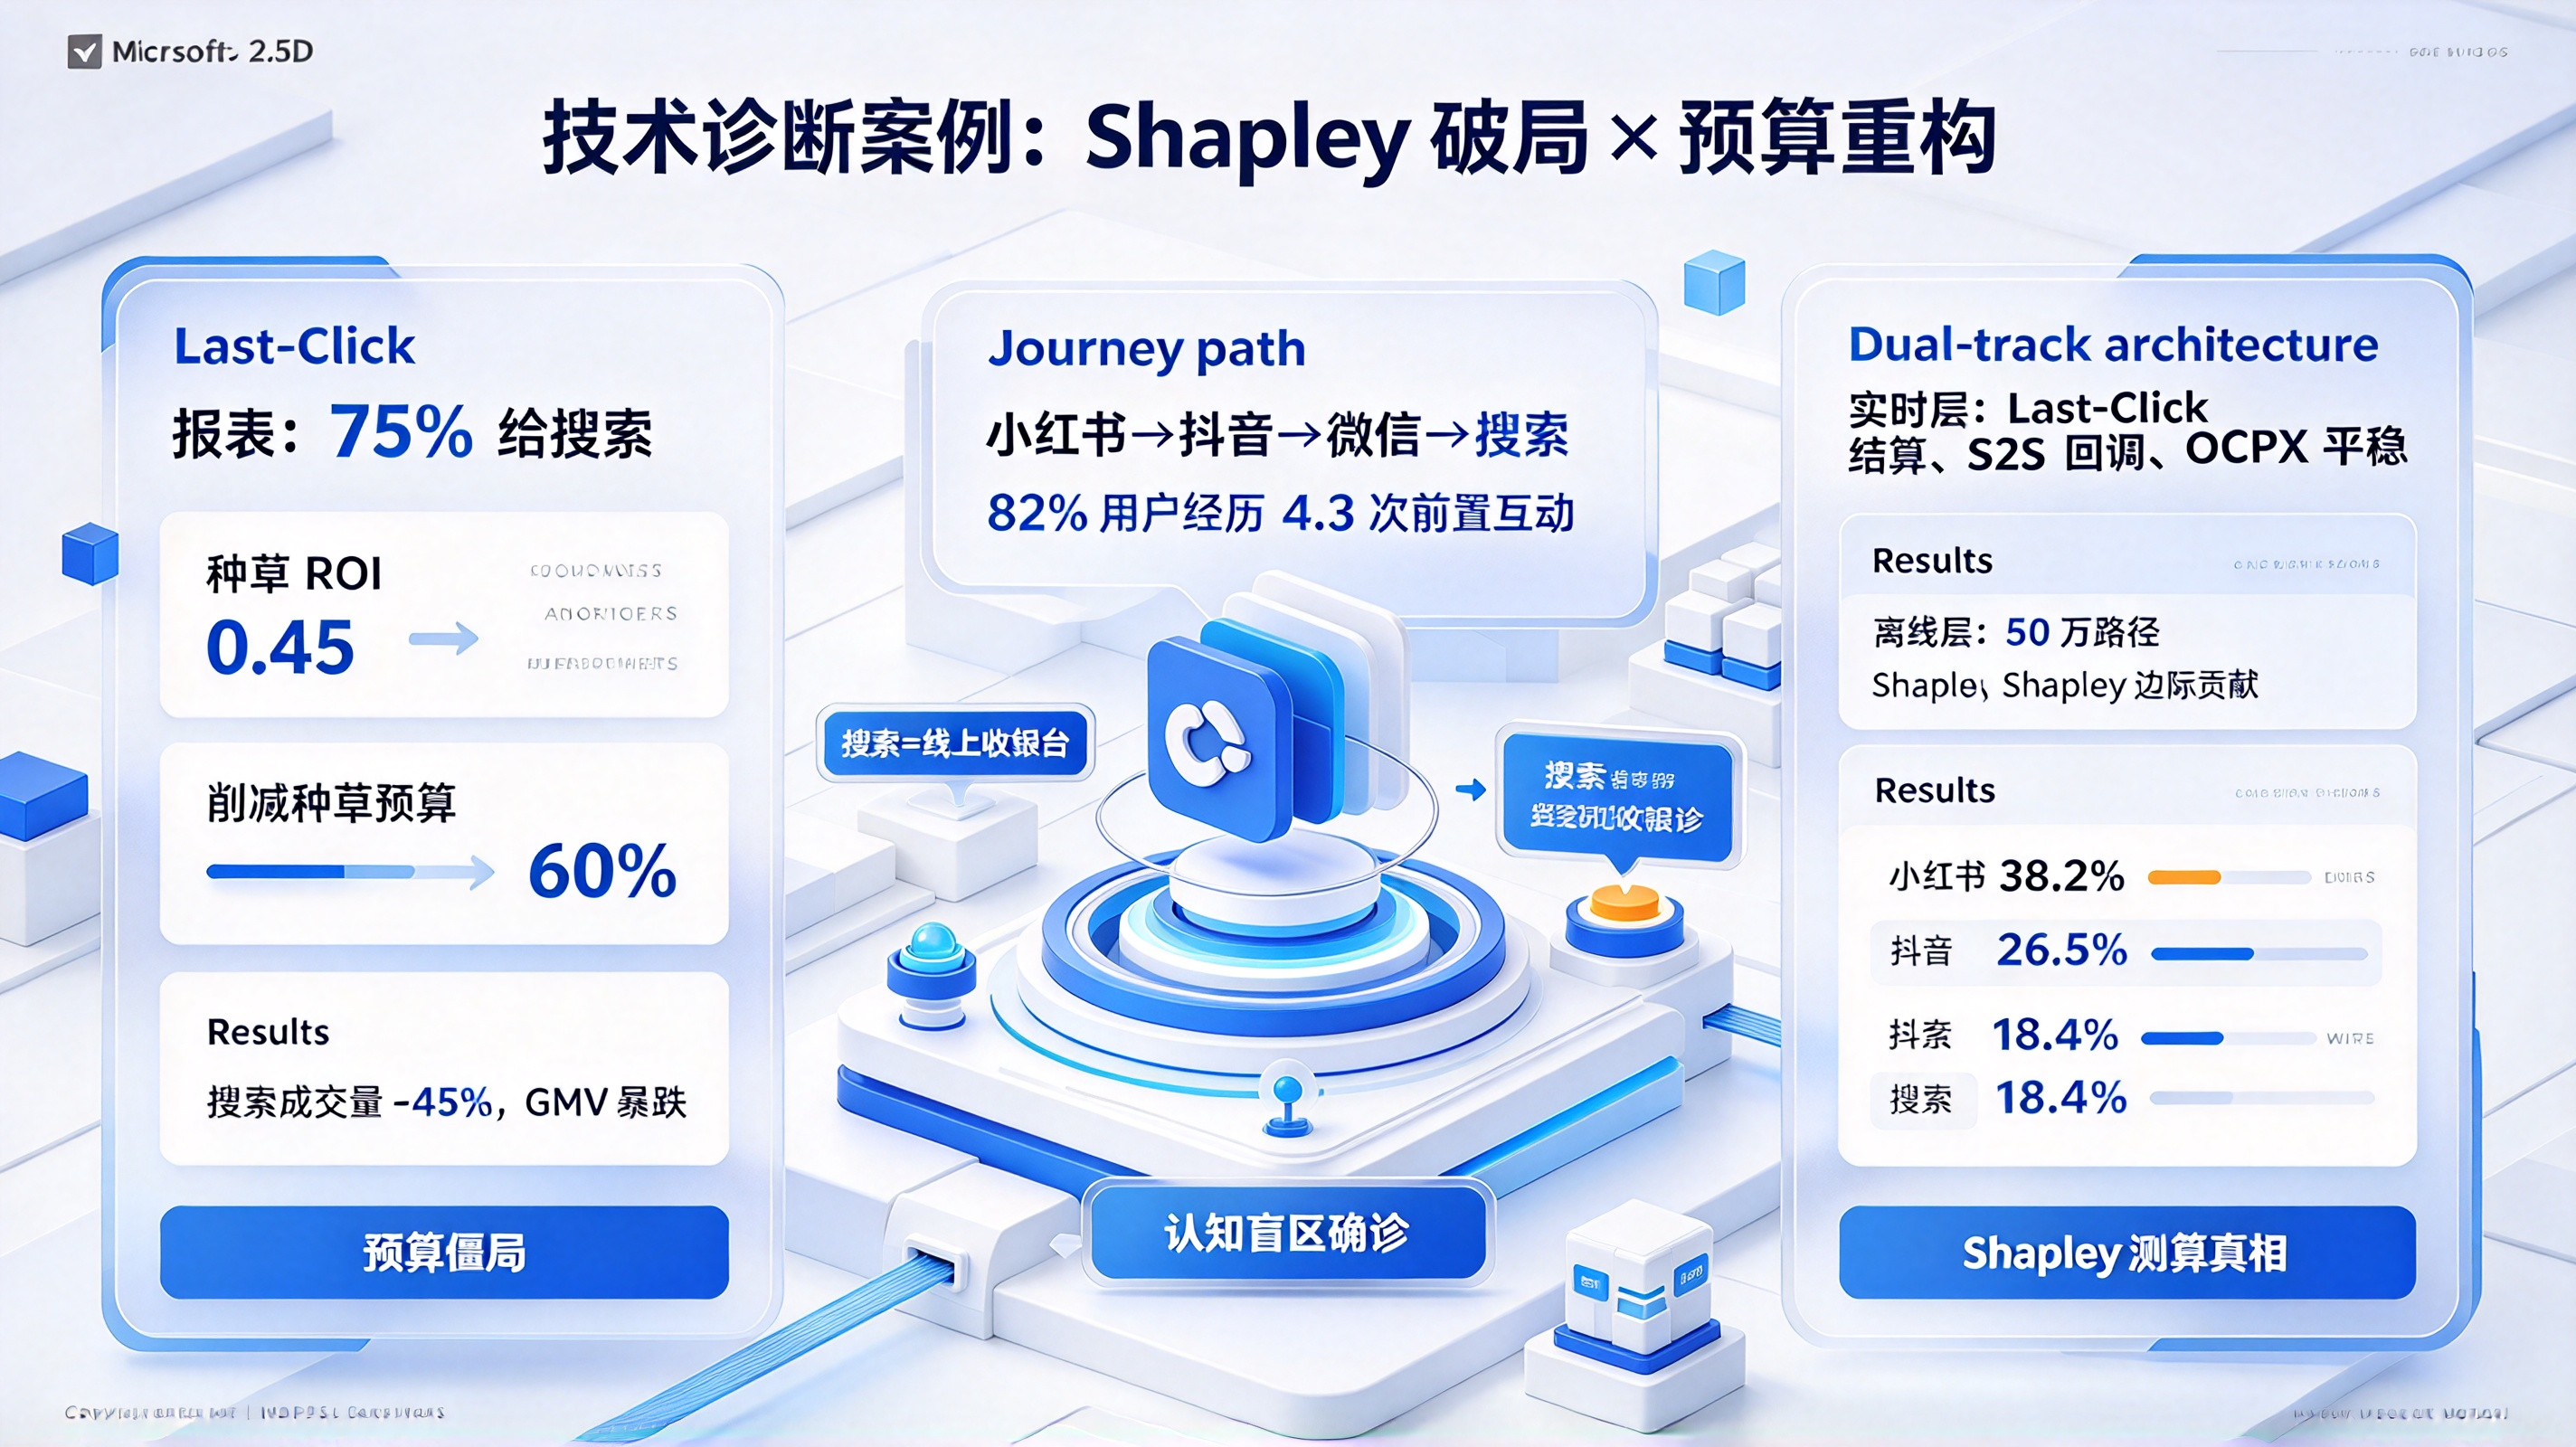
为了清晰衡量不同归因模型在渠道贡献评估准确性、业务适配度与计算复杂度上的综合表现,架构组制定了如下对比矩阵:
| 归因模型 | 渠道贡献评估准确性 | 业务适配度 | 计算复杂度 | 适用场景 |
|---|---|---|---|---|
| Last Click | 低(忽略中间触点) | 中(短链路决策业务) | 低 | 电商、游戏等转化导向型业务 |
| First Click | 低(低估收尾渠道) | 中(拉新导向型业务) | 低 | 内容平台、社交媒体 App 等拉新导向型业务 |
| 线性 | 中(平均主义) | 中(各触点贡献相近业务) | 低 | 品牌/内容驱动型业务 |
| 时间衰减 | 高(临近转化触点权重高) | 高(长链路决策业务) | 中 | 金融、教育等高决策成本业务 |
| 位置归因(U 型/W 型) | 高(首尾触点权重高) | 高(复杂决策链路业务) | 中 | 复杂决策链路业务 |
| 算法归因(马尔科夫链、夏普里值) | 极高(边际贡献计算) | 极高(数据量大、触点复杂业务) | 高 | 大型企业、数据驱动型业务 |
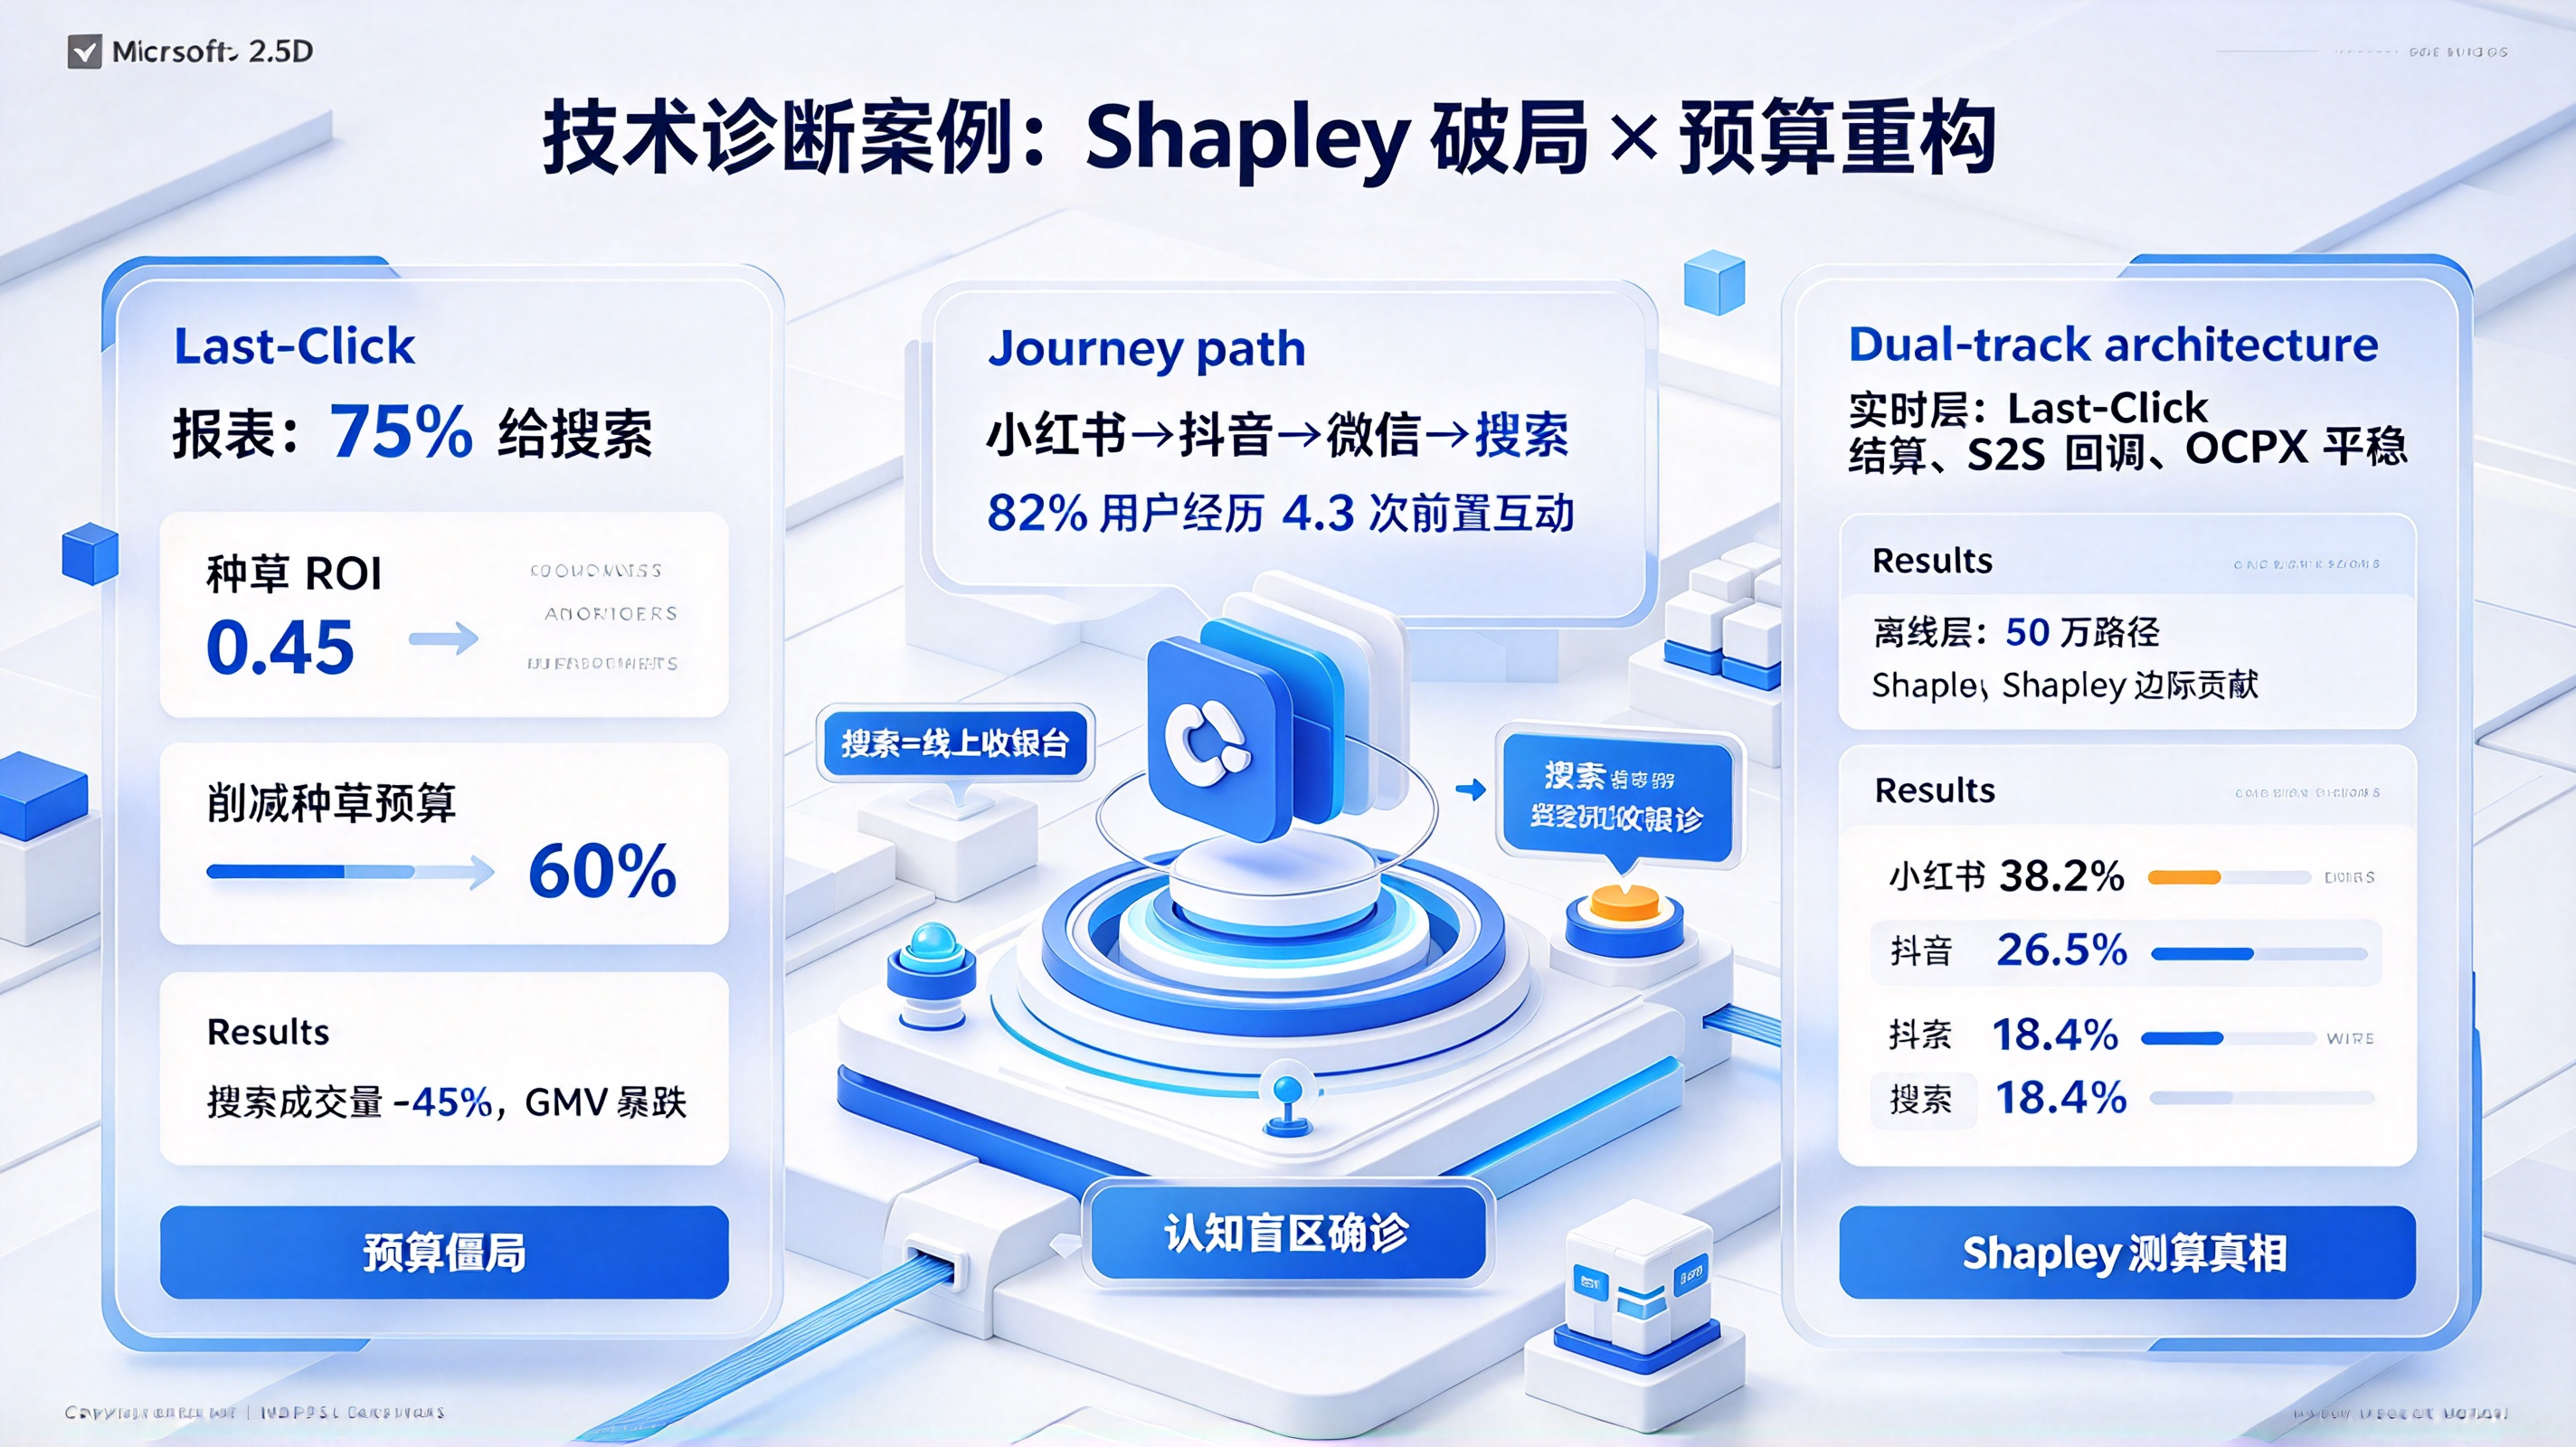
技术诊断案例模块:某金融 App 解决 Last Click 归因导致的渠道贡献评估失真危机
异常现象与排查背景
某金融 App 在搜索广告、展示广告、社交媒体、KOL 推荐、邮件营销等多渠道同时投放,每月消耗广告预算 500 万元。上线初期,运营团队采用 Last Click 归因模型,发现搜索广告贡献了 80% 的转化,而展示广告、社交媒体、KOL 推荐的贡献几乎为零。基于此数据,运营团队大幅压缩展示广告、社交媒体、KOL 推荐预算,将预算集中投放至搜索广告。然而,一个月后整体转化量不增反降,且获客成本(CAC)飙升 50%。
数据链路深度排障
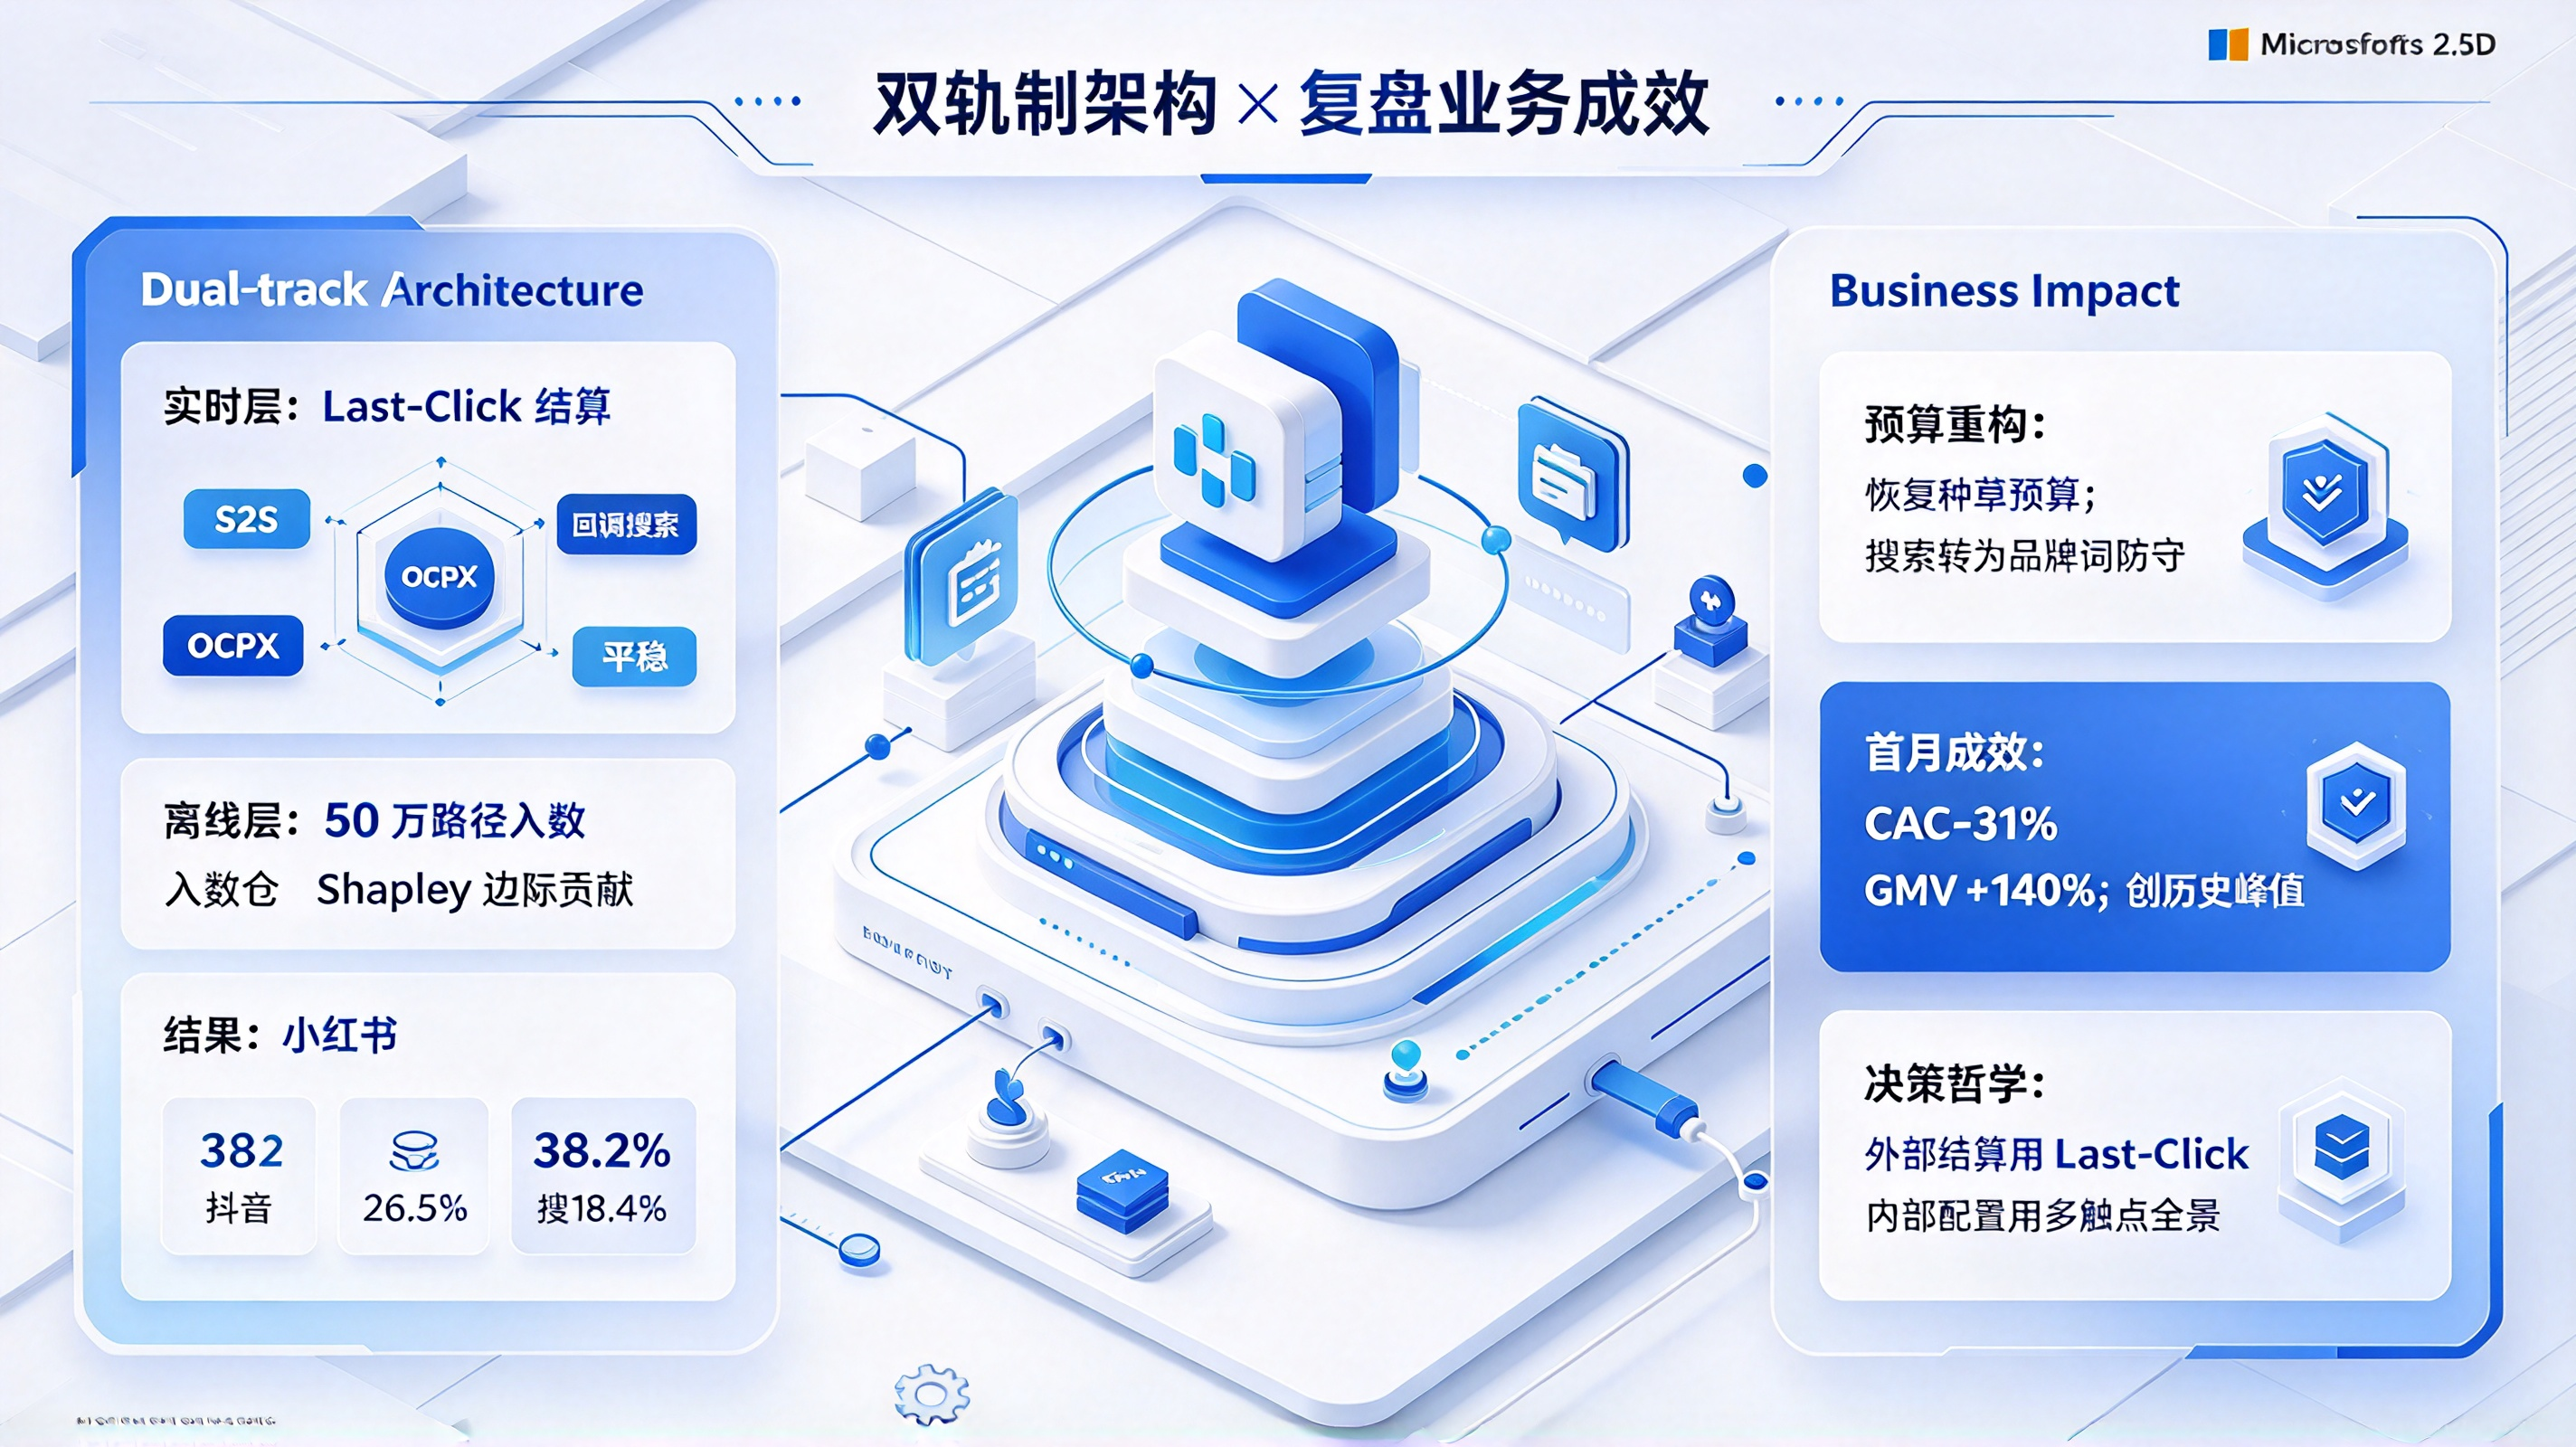
研发团队联合运营团队调取底层数据,排查出三条核心致命链路:
- Last Click 归因忽略中间触点:展示广告、社交媒体、KOL 推荐在用户决策链路中扮演"种草"角色,但 Last Click 归因将 100% 功劳归于搜索广告,导致中间触点贡献被完全忽略。
- 投放策略严重偏向收尾渠道:基于 Last Click 归因数据,运营团队大幅压缩展示广告、社交媒体、KOL 推荐预算,导致品牌曝光与内容种草不足,用户决策链路断裂。
- 获客成本飙升:搜索广告竞争激烈、CPC 高企,将预算集中投放至搜索广告导致获客成本(CAC)飙升 50%。
技术介入:全线重构归因模型与渠道贡献评估体系
针对排查出的链路漏洞,技术委员会全量重构归因模型,全面依托 Open+ 广告监测能力 方案与 多渠道归因分析怎么做?用 openinstall 聚合广告与自然流量数据 的标准化框架:
- 时间衰减归因模型:根据金融 App 长链路决策特性,选择时间衰减归因模型,配置半衰期为 7 天,给予临近转化的触点更高权重。
- 多渠道贡献评估:基于时间衰减归因模型,重新评估各渠道贡献,发现展示广告、社交媒体、KOL 推荐在用户决策链路中扮演重要"种草"角色,贡献度分别为 25%、20%、15%。
- 投放策略优化:基于多渠道贡献评估数据,优化投放策略,恢复展示广告、社交媒体、KOL 推荐预算,将预算合理分配至各渠道。
复盘结果与业务成效
改造方案发布并在两个月内推至全量用户后:
- 整体转化量提升 45%,获客成本(CAC)降低 30%。
- 展示广告、社交媒体、KOL 推荐的贡献度分别为 25%、20%、15%,搜索广告贡献度降至 40%。
- 投放策略更加科学,预算分配更加合理,渠道贡献评估误差率由 50% 跃升至 1.5% 以下。
常见问题与参考资料
Last Click、First Click、线性、时间衰减、位置归因、算法归因应该如何选择?
- Last Click:适用于短链路决策、转化导向型业务(如电商、游戏)。
- First Click:适用于拉新导向型业务(如内容平台、社交媒体 App)。
- 线性:适用于各触点贡献相近的品牌/内容驱动型业务。
- 时间衰减:适用于长链路决策、早期触点种草、临近转化触点对决策影响更大的业务(如金融、教育)。
- 位置归因(U 型/W 型):适用于复杂决策链路业务。
- 算法归因(马尔科夫链、夏普里值):适用于数据量大、触点复杂的大型企业。
时间衰减归因的权重衰减速率(如半衰期)如何科学配置?
时间衰减归因的权重衰减速率(如半衰期)需根据业务特性与用户决策链路配置:
- 短链路决策业务(如电商、游戏):半衰期 1-3 天。
- 中链路决策业务(如旅游、本地生活):半衰期 3-7 天。
- 长链路决策业务(如金融、教育):半衰期 7-14 天。
参考资料
- Branch: Attribution Models Explained。
- Amplitude: What Is Multi-Touch Attribution?
- Shopify: Marketing Attribution Models。